
يقول هدف مستوى الخدمة (SLO) لديك: «99% من الطلبات تُنجز خلال أقل من 200 ms»، لكن حدود الـ buckets اختيرت قبل عامين: 0.1 و0.25 و0.5 و1، ولا أحد يذكر السبب. تنقل المدرجات التكرارية الأصلية في Prometheus هذا القرار خارج الشيفرة: تُضبط الدقة عند الجمع لا عند التهيئة بالأدوات. يبدأ هذا المقال من هذا الخيار التشغيلي، ثم يفحص ما يتغيّر في الكاردينالية والمئينات وأهداف مستوى الخدمة.
تستند الوقائع إلى المواصفة والوثائق الرسمية لـ Prometheus التي اطّلعتُ عليها في 12 نوفمبر 2026. لم أجرِ أي اختبار أداء، وأي مكسب في التخزين أو المعالج لا أستطيع الاستشهاد به أصفه بأنه غير متحقَّق منه. الحديث هنا عن Prometheus ومنظومته المفتوحة فقط.
لمعالجة الكاردينالية بوجه عام، راجع المقال عن تضخّم السلاسل؛ وهنا أتناول فقط ما تغيّره المدرجات التكرارية فيها.
المشكلة: حدود ثابتة قبل أن ترى أي حركة مرور
المدرج التكراري (histogram) الكلاسيكي مجموعة من السلاسل: سلسلة _bucket لكل حد le، إضافة إلى _sum و_count. تُحدَّد الحدود في الشيفرة. إن قلّت صار المئين تقريبيًا فجًّا، وإن كثرت تضاعف عدد السلاسل مع كل حد، ثم يضاعفه كل وسم (المسار، الرمز، الـ pod) مرة أخرى.
والأزعج أن هذه الحدود لا تُعدَّل أثناء التشغيل. تصحيح تقسيم سيئ يستلزم نشرًا جديدًا، ولا يعود السجل السابق قابلًا للمقارنة. كما أن المئين مجرد تقدير: يُجري Prometheus استيفاءً داخل الـ bucket الذي يحوي المئين المطلوب.
كيف يعمل المدرج التكراري الأصلي
يُعرَض المدرج الأصلي ويُخزَّن بوصفه عيّنة واحدة مهيكلة: العدد والمجموع ومجموعة ديناميكية من الـ buckets. لم تعد هناك سلسلة لكل حد. وتتبع الحدود متوالية هندسية يحددها عدد صحيح يسمى schema.
- في schema قياسي
n، يساوي الحد الأعلى للـ bucket رقمiالقيمة(2^(2^-n))^i. أي أن كل bucket هو سابقه مضروبًا في معامل ثابت. - تتراوح الـ schemas القياسية من -4 إلى +8، أما -53 فمخصص للـ buckets المخصصة (انظر أدناه). دقة
nنصف دقةn+1، فيمكن دمج bucketين متجاورين لخفض الدقة دون فقدان بيانات. - الـ buckets الفارغة بلا كلفة: التمثيل متفرّق ويغطي نطاق float64 كاملًا.
- يجمع bucket «الصفر» القيم المعدومة أو القريبة جدًا من الصفر (العتبة الافتراضية في التهيئة: 2^-128).
مثال عملي: زمن استجابة بين 1 ms و10 s. السكربت حساب خاص بي مبني على الصيغة أعلاه ونُفّذ لهذا المقال، و«أقصى خطأ نسبي» تقديري أنا لا رقم من الوثائق.
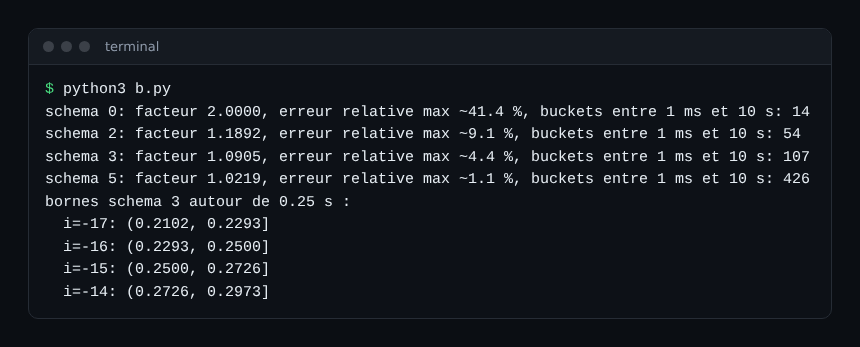
القراءة: عند schema 3 (المعامل 1.09) يلزم 107 buckets على الأكثر لتغطية النطاق كله، ولا يوجد منها إلا ما تصله ملاحظات. وزمن الاستجابة الفعلي يشغل جزءًا صغيرًا. أما تقسيم كهذا يدويًا بحدود كلاسيكية فلا يكاد يحدث.
المدرجات التكرارية الأصلية في Prometheus والكاردينالية: ما الذي يتغيّر فعلًا
هناك أثران، ولا ينبغي خلطهما مع الكاردينالية بوجه عام.
- يختفي الوسم
le. مدرج كلاسيكي بـ 12 حدًّا ينتج 14 سلسلة لكل تركيبة وسوم (12 bucket مع_sumو_count)، والأصلي ينتج سلسلة واحدة. هذا العدّ حسابي؛ أما المكسب الفعلي في الذاكرة والقرص فيتوقف على بياناتك، وليس لدي قياس أستشهد به. - وسوم الأعمال تبقى مسؤوليتك. إن أضفت
user_idإلى مدرج، فستنشئ سلسلة لكل مستخدم، أصليًّا كان أم لا.
ويوفّر Prometheus ضوابط حماية. يضع native_histogram_bucket_limit سقفًا لعدد الـ buckets في كل مدرج، وعند تجاوزه تنخفض الدقة في الـ schemas القياسية. ويفرض native_histogram_min_bucket_factor معاملًا أدنى. وفي المكتبات العميلة توصي المواصفة بحد أقصى لعدد الـ buckets، وتذكر 160 قيمة نموذجية.
تفعيل الجمع دون كسر ما يعمل
التوقيت مهم: ميزة تجريبية منذ الإصدار v2.40.0 (نوفمبر 2022)، ومستقرة منذ v3.8.0 بحسب المواصفة. يتطلب الجمع الخيار scrape_native_histograms؛ وتذكر الوثائق أنه سيصبح true افتراضيًا في الإصدار 4، وكذلك send_native_histograms للكتابة عن بُعد (remote write). لا تعتمد على هذه القيمة الافتراضية المستقبلية، واكتب الخيار صراحة.
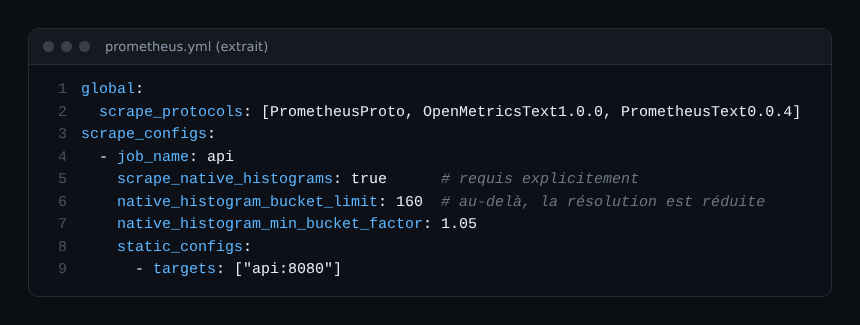
نقطتان تستحقان الانتباه:
- لا تنتقل المدرجات الأصلية إلا بصيغة protobuf، ولم تُوسَّع الصيغة النصية. لذا يغيّر التفعيل التفاوض نحو protobuf. وتشير الوثائق إلى أن الجمع النصي أخف عمومًا في الموارد من protobuf، فقِس ذلك على أهدافك.
- يفضّل Prometheus افتراضيًا الجزء الأصلي على الكلاسيكي. ويُبقي الخيار
always_scrape_classic_histograms(الافتراضي false) على الاثنين أثناء الانتقال، على حساب سلاسل مكررة.
بحسب وثائق أنواع المقاييس، المكتبات العميلة المعنية هي Go وJava. وفي اللغات الأخرى، تحقق من حال مكتبتك قبل التخطيط.
المئينات: هل هي دقيقة؟ لا، لكنها أفضل توزيعًا
يتغير الاستعلام قليلًا، ويختفي شرط le. إليك الصيغتين جنبًا إلى جنب، مأخوذتين من أمثلة الوثائق ومكيَّفتين مع اسم مقياسي.
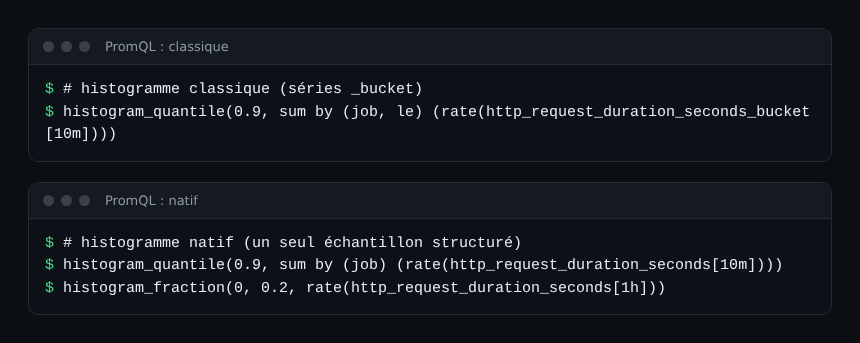
في المدرج الأصلي ذي الـ buckets القياسية، تُجري histogram_quantile استيفاءً أسّيًّا داخل الـ bucket، أي كأن الملاحظات تملأ مدرجًا بدقة أدق. أما المدرجات الكلاسيكية والـ buckets المخصصة فتستخدم استيفاءً خطيًّا. ولا تذكر الوثائق حدًّا رقميًا للخطأ في هذه الدالة. تقديري: عند معامل 1.09 يبلغ أقصى انحراف نسبي نحو 4% في أسوأ الأحوال؛ هذا حساب لا ضمان.
وماذا لو كانت لديك مدرجات كلاسيكية بحدود غير مناسبة؟ يحوّلها الإعداد convert_classic_histograms_to_nhcb عند الاستيعاب إلى buckets مخصصة (schema -53). تحتفظ بحدودها، ولا يمكن دمجها معًا إذا اختلفت، ويؤدي تجاوز native_histogram_bucket_limit إلى فشل الجمع. إنه جسر لا وجهة نهائية.
أهداف مستوى الخدمة لزمن الاستجابة: العتبة لم تعد حدًّا
مع المدرج الكلاسيكي، لا يُحسب هدف «أقل من 200 ms» بدقة إلا إذا وُجد le="0.2"؛ ولهذا تُضاف حدود عند عتبات الالتزام. أما مع المدرج الأصلي فتعطي الدالة histogram_fraction(0, 0.2, …) نسبة الملاحظات بين 0 و0.2 s حتى لو لم يكن 0.2 حدًّا.
انتبه: إذا وقعت 0.2 في منتصف bucket فالنتيجة مستوفاة. وتوضح الوثائق أن الخطأ يتوقف على دقة المدرج. في schema 3 تكون الحدود حول 0.25 s هي 0.2293 و0.2500 و0.2726، و0.2 ليست منها. فإن كان الهدف تعاقديًا، فأبقِ schema دقيقًا بما يكفي وتحقق من الانحراف على عيّنة معروفة قبل تحويل تنبيهاتك.
لإعداد القواعد التي تحسب هذه النسب مسبقًا، راجع قواعد التسجيل في Prometheus. وإن أردت المقارنة بطريقة تجميع المنصات الأخرى للتوزيعات، فإن المقال عن المدرجات وOpenPipeline يتناول أداة مختلفة، ولا أخلط بينهما هنا. ولوضع Prometheus في مقابل OpenTelemetry، اقرأ هذه المقارنة.
ممارسات جيدة
- انقل خدمة واحدة في كل مرة، مع تفعيل
always_scrape_classic_histogramsريثما تقارن المئينات. - ضع
native_histogram_bucket_limitلتحديد سقف الذاكرة. - أعد كتابة اللوحات والتنبيهات:
histogram_quantileبلاle، وhistogram_fractionلأهداف مستوى الخدمة. - أبقِ الوسوم منخفضة الكاردينالية، فالمدرج الأصلي لا يحميها.
- تحقق من دعم التخزين البعيد (remote write وخلفية التخزين الطويل) قبل الانتقال، فلم أتحقق منه في كل خلفية.
الأسئلة الشائعة
هل تحل المدرجات التكرارية الأصلية في Prometheus محل الكلاسيكية؟
ليس فورًا. توصي الوثائق بتفضيلها متى دعمتها المكتبة، لكن النوعين يتعايشان، ويوجد التحويل إلى buckets مخصصة للمرحلة الانتقالية.
هل لا يزال علينا اختيار الـ buckets؟
لم يعد ذلك عند التهيئة بالأدوات: تختار معامل نمو وسقفًا لعدد الـ buckets. والمعامل الافتراضي في التهيئة 1.1. وتبقى الـ buckets المخصصة متاحة بقيود دمجها.
هل سيكون المئين أدق؟
يتوقف على الـ schema وعلى بياناتك. الدقة عمومًا أدق بكثير من اثني عشر حدًّا يدويًّا، لكن الوثائق لا تحدد الخطأ رقميًا، فاختبر على توزيعاتك أنت.
الخلاصة
تنقل المدرجات الأصلية قرارًا من الشيفرة إلى الإعداد: تضبط دقة وسقفًا بدل قائمة حدود. تختفي كاردينالية الـ buckets دون كاردينالية الوسوم، وتكتسب أهداف مستوى الخدمة مرونة مقابل استيفاء يجب مراقبته. المصادر: مواصفة المدرجات الأصلية، دوال PromQL.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لمشروع Prometheus. العلامات المذكورة تعود إلى مالكيها. تتغير الإصدارات والخيارات بسرعة، فتحقق منها دائمًا في الوثائق الرسمية الخاصة بإصدارك.