
Tu SLO de latencia dice «el 99 % de las peticiones por debajo de 200 ms», pero los buckets los elegiste hace dos años: 0,1; 0,25; 0,5; 1. Nadie recuerda por qué. Los histogramas nativos de Prometheus sacan esa decisión del código: la resolución se ajusta al recolectar, no al instrumentar. Parto de esa decisión operativa y luego reviso qué cambia en la cardinalidad, los percentiles y los SLO.
Los datos salen de la especificación y de la documentación oficiales de Prometheus, consultadas el 12 de noviembre de 2026. No he ejecutado ningún banco de pruebas: cualquier ahorro de almacenamiento o de CPU que no pueda citar queda marcado como no verificado. Aquí solo hablo de Prometheus y de su ecosistema abierto.
Para la cardinalidad en general, mira el artículo sobre las series que se disparan; aquí solo trato lo que los histogramas cambian en ese terreno.
El problema: buckets fijados antes de ver el tráfico
Un histograma clásico es un conjunto de series: una serie _bucket por cada límite le, más _sum y _count. Los límites se fijan en el código. Si pones pocos, el percentil sale tosco; si pones muchos, cada límite multiplica las series, y después cada etiqueta (ruta, código, pod) las multiplica otra vez.
Lo más incómodo es que esos límites no se cambian en caliente. Corregir un mal reparto exige un despliegue, y el histórico anterior deja de ser comparable. Además, el percentil es una estimación: Prometheus interpola dentro del bucket que contiene el cuantil.
Cómo funciona un histograma nativo
Un histograma nativo se expone y se almacena como una sola muestra estructurada: contador, suma y un conjunto dinámico de buckets. Ya no hay una serie por límite. Los límites siguen una progresión geométrica definida por un entero, el schema.
- Con un schema estándar
n, el límite superior del bucketies(2^(2^-n))^i. Cada bucket es, por tanto, el anterior multiplicado por un factor constante. - Los schemas estándar van de -4 a +8; el schema -53 se reserva para los buckets personalizados (más abajo). El schema
ntiene la mitad de resolución que eln+1, de modo que dos buckets vecinos se pueden fusionar para bajar la resolución sin perder datos. - Los buckets vacíos no cuestan nada: la representación es dispersa y cubre todo el rango de un float64.
- Un bucket «cero» recoge los valores nulos o muy cercanos a cero (umbral por defecto en la instrumentación: 2^-128).
Un caso concreto: una latencia entre 1 ms y 10 s. El script es un cálculo propio a partir de la fórmula anterior, ejecutado para este artículo; el «error relativo máx.» es una estimación mía, no una cifra de la documentación.
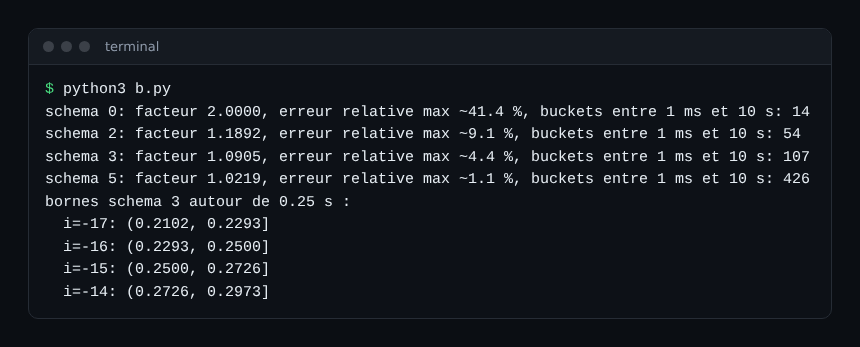
Cómo leerlo: con el schema 3 (factor 1,09), cubrir todo el rango exige como máximo 107 buckets, y solo existen los que reciben observaciones. Una latencia real ocupa una fracción. Hacer un reparto así a mano, con límites clásicos, casi nunca se hace.
Histogramas nativos de Prometheus y cardinalidad: qué cambia de verdad
Hay dos efectos, que conviene no confundir con la cardinalidad en general.
- La etiqueta
ledesaparece. Un histograma clásico con 12 límites genera 14 series por combinación de etiquetas (12 buckets,_sumy_count). El nativo genera una. La cuenta es aritmética; la ganancia real en memoria y disco depende de tus datos y no tengo ninguna medición que citar. - Las etiquetas de negocio siguen siendo cosa tuya. Si añades
user_ida un histograma, sigues creando una serie por usuario, sea nativo o no.
Prometheus ofrece además algunas protecciones. native_histogram_bucket_limit pone un tope al número de buckets por histograma: al superarlo, baja la resolución en los schemas estándar. native_histogram_min_bucket_factor impone un factor mínimo. En las bibliotecas cliente, la especificación recomienda un máximo de buckets y cita 160 como valor típico.
Activar la recolección sin romper lo que ya funciona
El calendario importa: función experimental desde la v2.40.0 (noviembre de 2022) y estable desde la v3.8.0, según la especificación. La recolección requiere scrape_native_histograms; según la documentación, en la v4 pasa a true por defecto, igual que send_native_histograms para el remote write. No cuentes con ese futuro valor por defecto: escribe la opción.
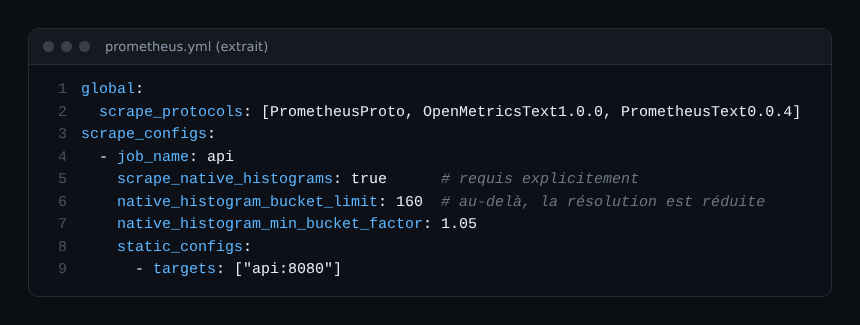
Dos puntos de atención:
- Los histogramas nativos solo viajan en protobuf; el formato de texto no se ha ampliado. Activar la opción cambia, pues, la negociación hacia protobuf. La documentación señala que los scrapes en texto suelen consumir bastante menos recursos que los de protobuf: mide en tus targets.
- Por defecto, Prometheus prefiere la parte nativa a la clásica.
always_scrape_classic_histograms(falso por defecto) conserva ambas durante la migración, a costa de series duplicadas.
Según la documentación sobre tipos de métricas, las bibliotecas cliente compatibles son las de Go y Java. Para otros lenguajes, comprueba el estado de tu biblioteca antes de planificar.
Percentiles: ¿exactos? No, pero mejor repartidos
La consulta cambia poco, y la cláusula le desaparece. Aquí van las dos formas una al lado de la otra, tomadas de los ejemplos de la documentación y adaptadas a mi nombre de métrica.
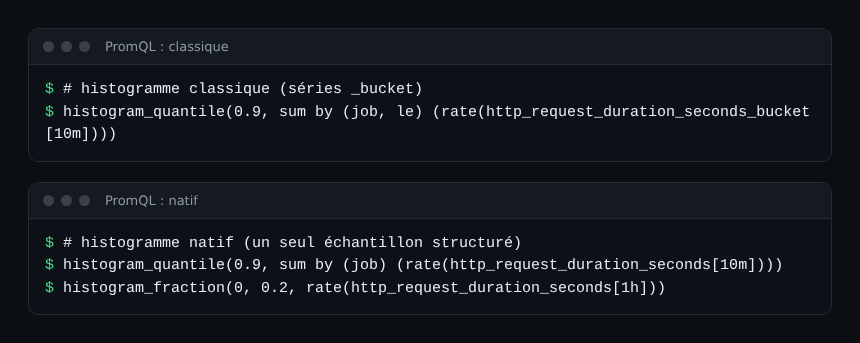
En un histograma nativo con buckets estándar, histogram_quantile interpola de forma exponencial dentro del bucket, es decir, como si las observaciones llenaran un histograma de resolución más fina. Los histogramas clásicos y los buckets personalizados usan interpolación lineal. La documentación no da una cota de error numérica para esta función. Mi estimación: con un factor de 1,09, la desviación relativa máxima ronda el 4 % en el peor caso; es un cálculo, no una garantía.
¿Y si ya tienes histogramas clásicos con límites poco adecuados? El parámetro convert_classic_histograms_to_nhcb los convierte al ingerirlos en buckets personalizados (schema -53). Conservan sus límites, no se pueden fusionar entre sí cuando difieren, y superar native_histogram_bucket_limit hace fallar el scrape. Es un puente, no un destino.
SLO de latencia: el umbral ya no tiene que ser un límite
Con un histograma clásico, un SLO «por debajo de 200 ms» solo se calcula bien si existe le="0.2". Por eso se añaden límites en los umbrales de compromiso. Con un histograma nativo, la función histogram_fraction(0, 0.2, …) da la proporción de observaciones entre 0 y 0,2 s aunque 0,2 no sea un límite.
Ojo: si 0,2 cae en mitad de un bucket, el resultado es interpolado. La documentación aclara que el error depende de la resolución del histograma. En el schema 3, los límites alrededor de 0,25 s son 0,2293; 0,2500; 0,2726; 0,2 no es uno de ellos. Para un SLO contractual, mantén un schema suficientemente fino y comprueba la desviación con una muestra conocida antes de cambiar tus alertas.
Para montar las reglas que precalculan estos ratios, mira las recording rules de Prometheus. Si quieres comparar con la forma en que otras plataformas agregan distribuciones, el artículo sobre histogramas y OpenPipeline trata otra herramienta; aquí no las mezclo. Para situar Prometheus frente a OpenTelemetry, lee esta comparativa.
Buenas prácticas
- Migra un servicio cada vez, con
always_scrape_classic_histogramsactivo mientras comparas percentiles. - Fija un
native_histogram_bucket_limitpara acotar la memoria. - Reescribe dashboards y alertas:
histogram_quantilesinleyhistogram_fractionpara los SLO. - Mantén las etiquetas con baja cardinalidad: el histograma nativo no las protege.
- Comprueba el soporte del almacenamiento remoto (remote write, backend a largo plazo) antes de migrar: no lo he verificado en cada backend.
Preguntas frecuentes
¿Los histogramas nativos de Prometheus sustituyen a los clásicos?
No de inmediato. La documentación recomienda preferirlos cuando la biblioteca los admite, pero conviven, y existe la conversión a buckets personalizados para la transición.
¿Hay que seguir eligiendo buckets?
Ya no al instrumentar: eliges un factor de crecimiento y un tope de buckets. El factor por defecto en la instrumentación es 1,1. Los buckets personalizados siguen disponibles, con sus límites de fusión.
¿Mi percentil será más preciso?
Depende del schema y de tus datos. La resolución suele ser mucho más fina que con una docena de límites manuales, pero la documentación no cuantifica el error: prueba con tus propias distribuciones.
Conclusión
Los histogramas nativos trasladan una decisión del código a la configuración: ajustas una resolución y un tope, no una lista de límites. La cardinalidad de los buckets desaparece, la de las etiquetas no, y los SLO ganan flexibilidad a cambio de una interpolación que hay que vigilar. Fuentes: especificación de los histogramas nativos, funciones de PromQL.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni al proyecto Prometheus. Las marcas citadas pertenecen a sus propietarios. Las versiones y opciones cambian deprisa: compruébalas en la documentación oficial correspondiente a tu versión.