كاردينالية مقاييس Kubernetes: تأتي التكلفة من التسميات (labels) قبل حركة التطبيقات بوقت طويل. كل توليفة فريدة من التسميات تنشئ سلسلة زمنية مستقلة، وجزء كبير من هذه السلاسل لا يظهر أبدًا، لا في لوحة معلومات ولا في قاعدة تنبيه. ومع ذلك تُجمع وتُخزَّن وتُحتسب في الفاتورة أو في تقدير الموارد مثل غيرها.
يقترح هذا الدليل منهجًا من أربع مراحل: القياس، ثم كشف المقاييس التي لا يقرؤها أحد، ثم الحذف عند المصدر، ثم وضع ضوابط وقائية. تعتمد الأمثلة على Prometheus وkube-state-metrics، وهما الإعداد الأكثر انتشارًا. وتبقى الفكرة صالحة مع OpenTelemetry Collector الذي يرسل إلى Dynatrace SaaS أو Managed. وهو يكمّل الوحدة المخصصة لـمقاييس Kubernetes في Grail.
باختصار
- السلسلة = اسم مقياس + مجموعة تسميات. تسمية إضافية واحدة قد تضاعف عدد السلاسل.
- تصنّف واجهة
/api/v1/status/tsdbفي Prometheus المقاييس والتسميات الأكثر كلفة. - يتم الحذف على ثلاثة مستويات: المُصدِّر (exporter)، وجمع البيانات (
metric_relabel_configs)، وCollector. - يحمي السقف
sample_limitالمنصة، لكنه يُفشل الـ scrape بأكمله عند تجاوزه.
لماذا تنفجر كاردينالية مقاييس Kubernetes
وفق وثائق Prometheus حول التسمية، تمثّل كل توليفة فريدة من أزواج المفتاح والقيمة للتسميات سلسلة زمنية جديدة، ما قد يزيد حجم التخزين زيادة كبيرة. وتنصح الصفحة بعدم استخدام التسميات للأبعاد عالية الكاردينالية، مثل معرّفات المستخدمين أو عناوين البريد الإلكتروني.
ينتج Kubernetes هذه المشكلة بطبيعته. فلكل pod اسم ومعرّف فريدان، وكل عملية نشر تنشئ أسماء ومعرّفات جديدة. وتحمل مقاييس kube-state-metrics مثلًا التسميات pod وnamespace وuid، بحسب وثائق مقاييس الـ pods. ويضيف المقياس kube_pod_container_info التسميات image وimage_id وcontainer_id. مع كل إعادة نشر تتغير هذه القيم وتظهر سلاسل جديدة.
فالتكلفة لا تأتي من عدد الـ pods وحده، بل أيضًا من معدل التجدد: سلاسل قديمة تختفي وأخرى تولد، وعلى قاعدة البيانات أن تفهرس كل شيء. وهذا الموضوع مختلف عن التنبيه على العُقد والحصص: هنا نقلّل ما يُجمع بدل أن نقرر ما نراقبه.
الخطوة 1: القياس عبر واجهة TSDB في Prometheus
قبل الحذف، يجب معرفة أين يذهب الحجم. تجيب واجهة حالة TSDB عن هذا السؤال. بحسب وثائق واجهة HTTP، نقطة النهاية هي GET /api/v1/status/tsdb، وقد أُضيفت في الإصدار 3.6.0 بحسب الصفحة نفسها. يحدّد المعامل الاختياري limit عدد العناصر لكل إحصائية (10 افتراضيًا و10 000 كحد أقصى).
curl -s 'http://localhost:9090/api/v1/status/tsdb?limit=20'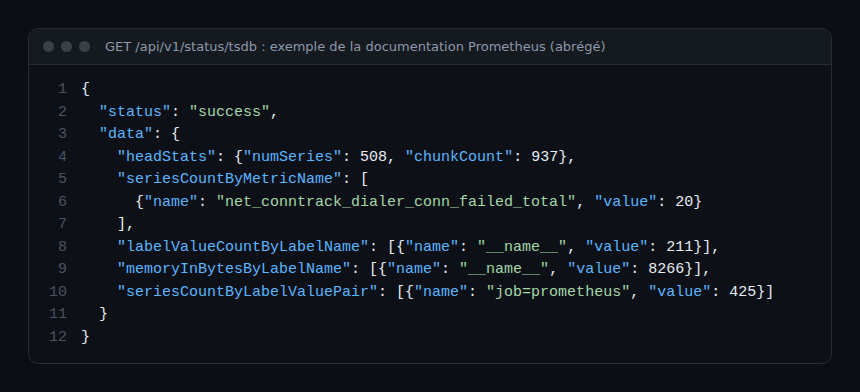
تعطي الاستجابة خمس كتل مفيدة:
headStats: العدد الإجمالي للسلاسل (numSeries) وللـ chunks في كتلة الرأس؛seriesCountByMetricName: المقاييس الأكثر سلاسل؛labelValueCountByLabelName: التسميات الأكثر قيمًا مختلفة؛memoryInBytesByLabelName: الذاكرة المستهلكة لكل تسمية، وتُحسب بجمع أطوال كل القيم؛seriesCountByLabelValuePair: أزواج label=value التي تتركز فيها أكثر السلاسل.
تسمّي الصفحة الحقل الأخير بطريقتين: القائمة تذكر seriesCountByLabelPair والمثال يذكر seriesCountByLabelValuePair. تحقق من الاسم الدقيق على خادمك.
الخطوة 2: كشف المقاييس التي لا يقرؤها أحد
المقياس «الذي لا يُقرأ أبدًا» لا يظهر في قاعدة تنبيه ولا في لوحة معلومات ولا في استعلام مناوبة. لا توجد واجهة تكشفه تلقائيًا: يتم الجرد يدويًا بمقارنة قائمتين.
- صدّر أسماء المقاييس العشرة إلى العشرين الأكبر حجمًا من
seriesCountByMetricName. - ابحث عن كل اسم في قواعد التنبيه وقواعد التسجيل (recording rules) ولوحات المعلومات (يكفي أمر
grepبسيط على مستودع الإعدادات). - لكل مقياس لا تجده، اسأل الفريق المالك: من استخدمه آخر مرة، ولأي حادثة؟
- صنّف: يُحتفظ به، يُحتفظ به دون بعض التسميات، يُحذف.
نحتفظ بالإشارات التي تخدم SLI أو تشخيصًا، ونزيل الباقي لتقليل الـ toil. ويذكّر النص حول قابلية الملاحظة والمراقبة بأن جمع المزيد لا يغني عن جمع ما يلزم.
الخطوة 3: الحذف عند المصدر في kube-state-metrics
الأوفر هو ألا ننتج المقياس أصلًا. بحسب وثائق معاملات kube-state-metrics، تهمّ ثلاثة خيارات:
--resources: قائمة الموارد المفعّلة، مفصولة بفواصل؛--metric-denylist: المقاييس التي لا تُفعَّل، بالاسم الدقيق أو بتعبير نمطي (regex)؛--metric-labels-allowlist: تسميات Kubernetes التي تُضاف إلى مقياس تسميات المورد.
الخياران --metric-allowlist و--metric-denylist متنافيان. اختر أحدهما.
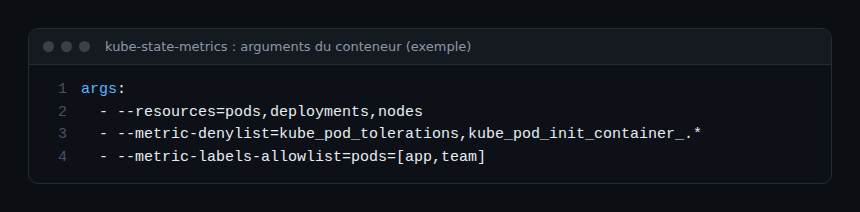
في المثال أعلاه تُصدَّر ثلاثة أنواع من الموارد فقط، وتُستبعد عائلتان من المقاييس التجريبية، ولا تُنسخ إلا التسميتان app وteam من الـ pods. بحسب وثائق مقاييس الـ pods، فإن kube_pod_tolerations موسومة بـ EXPERIMENTAL، وكذلك مقاييس الحالة التفصيلية kube_pod_init_container_*. أعد قراءة صفحة الإصدار المنشور قبل نسخ هذه القائمة.
الخطوة 4: الحذف عند الجمع باستخدام metric_relabel_configs
عندما لا يمكن تعديل المُصدِّر، يستطيع Prometheus استبعاد سلاسل قبل الاستيعاب. يوضح مرجع الإعدادات أن إعادة وسم المقاييس تُطبَّق على العينات بوصفها الخطوة الأخيرة قبل الاستيعاب، بالصيغة نفسها والإجراءات نفسها المستخدمة في إعادة وسم الأهداف. ويذكر استبعاد السلاسل شديدة الكلفة ضمن الاستخدامات. ولا تُطبَّق على السلاسل المولَّدة تلقائيًا مثل up.
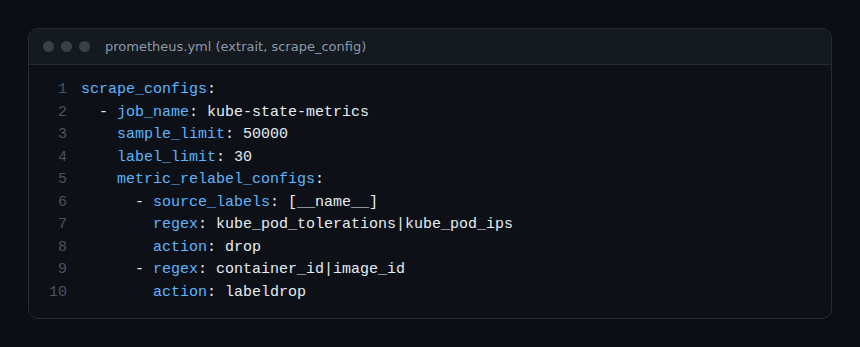
يُستخدم هنا إجراءان:
drop: يحذف السلاسل التي يطابقregexفيها قيمsource_labelsبعد دمجها (هنا اسم المقياس__name__)؛labeldrop: يزيل التسميات التي يطابق اسمهاregex.
احذر مع labeldrop. تطلب الوثائق التأكد من أن المقاييس تبقى معرَّفة تعريفًا فريدًا بعد إزالة التسميات. وإذا صارت سلسلتان متطابقتين تتصادمان. لذلك أزل أولًا التسميات التي لا تعرّف شيئًا مفيدًا، مثل معرّف الحاوية، وتحقق من الأثر على numSeries بعد التعديل.
الخطوة 5: وضع ضوابط وقائية
تحوّل حدود الـ scrape خطرًا صامتًا إلى تنبيه ظاهر. بحسب المرجع نفسه، يحدّد sample_limit حدًا لكل scrape على عدد العينات المقبولة. ويتم العدّ بعد إعادة وسم المقاييس، وعند التجاوز يُعدّ الـ scrape بأكمله فاشلًا. القيمة 0 تعني «بلا حد». أما label_limit فيحدّ عدد التسميات لكل عينة، بالسلوك نفسه عند التجاوز.
لهذا السلوك ثمن: التجاوز يفقدك كل مقاييس الهدف، لا السلاسل الزائدة فقط. اضبط الحد إذن بهامش، مثلًا فوق أقصى قيمة لوحظت، ونبّه على فشل الـ scrape (تصبح السلسلة up تساوي 0). السقف يخدم كشف الانحراف، لا استبدال الجرد في الخطوتين 1 و2.
من جهة OpenTelemetry: التصفية في Collector
إذا كانت المقاييس تمر عبر Collector، فإن المعالج filter يستبعد البيانات قبل التصدير. يعطي README المعالج filter المفتاح الحالي metric_conditions، ويشير إلى أن المفتاح القديم metrics.metric مُهمَل وسيُزال. ويحذف مثاله نقاط مقياس وفق شرط OTTL:
processors:
  filter:
    error_mode: ignore
    metric_conditions:
      - metric.name == "k8s.pod.phase" and datapoint.value_int == 4
هذا المثال مأخوذ من الوثائق. استبدل الشرط بشرطك بعد اختباره في بيئة غير حرجة. وللنشر الكامل لـCollector راجع دليل Collector على Kubernetes؛ وللمقارنة بين العالمين راجع OpenTelemetry وPrometheus. ويُشرح مسار Prometheus نحو Dynatrace في هذا المقال.
كيف تتحقق من أن الأمر يعمل
- أعد تشغيل
curl 'http://localhost:9090/api/v1/status/tsdb?limit=20'وقارنnumSeriesقبل التعديل وبعده خلال مدة مماثلة. - تأكد من أن المقاييس المحذوفة لم تعد تظهر في
seriesCountByMetricName. - تحقق من أن التنبيهات ولوحات المعلومات الحرجة ما زالت تعيد بيانات.
- راقب حالة الأهداف:
sample_limitالمنخفض جدًا يظهر في صورة scrape فاشل.
أفضل الممارسات
- قس قبل أن تحذف، ودوّن قيمة
numSeriesالأولية. - فضّل قائمة سماح للموارد على قائمة منع عندما يكون النطاق معروفًا.
- لا تستخدم أبدًا تسمية ذات قيم غير محدودة في مقاييسك الخاصة.
الأسئلة الشائعة
ما هي كاردينالية المقياس؟
هي عدد السلاسل الزمنية المختلفة التي ينتجها، أي عدد توليفات قيم التسميات الملاحَظة. وكلما زادت القيم الممكنة لتسمية ما ارتفعت الكاردينالية.
كيف أعرف أي المقاييس هي الأكثر كلفة؟
استعلم عن واجهة /api/v1/status/tsdb في Prometheus: فهي تصنّف المقاييس بعدد السلاسل والتسميات بعدد القيم المختلفة. هذه الواجهة متاحة بدءًا من الإصدار 3.6.0 بحسب الوثائق.
هل يمكن فقدان معلومات مفيدة عند حذف التسميات؟
نعم. إزالة تسمية باستخدام labeldrop قد تدمج سلاسل أو تخفي بعدًا تحليليًا. تحقق أولًا من أنه لا تنبيه ولا لوحة معلومات تستخدمها، وجرّب على job واحد للـ scrape.
الخلاصة
خفض كاردينالية مقاييس Kubernetes ليس تمرينًا في الضغط، بل فرزًا حسب الاستخدام. القياس عبر واجهة TSDB، وإيجاد المقاييس التي لا قارئ لها، والحذف عند المصدر ثم وضع سقف للـ scrape، كل ذلك يكفي لاستعادة السيطرة على الفاتورة دون المساس بالإشارات التي تخدم SLO.
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC. Dynatrace علامة تجارية لشركة Dynatrace LLC؛ وأسماء المنتجات المذكورة (Prometheus وkube-state-metrics وOpenTelemetry وKubernetes) تعود إلى مالكيها. الإعدادات أمثلة يجب تكييفها واختبارها قبل أي استخدام في الإنتاج. تحقق دائمًا من القيم (المنافذ والإصدارات والأحجام) في الوثائق الرسمية الخاصة بإصدارك.