Son las once de la noche de un viernes y alguien despliega una build en el espacio de nombres pruebas. A los pocos minutos, un contenedor de ese espacio empieza a abrir conexiones contra la base de datos de produccion. Nadie lo ha autorizado, pero nadie lo impide: en Kubernetes, el comportamiento de fábrica es que todo habla con todo. Una NetworkPolicy Kubernetes es la herramienta para levantar tabiques donde el clúster no pone ninguno. Aquí sigo el orden que yo recomiendo: cerrar un espacio de nombres, abrir solo los pasos necesarios y demostrar que cada tabique aguanta.
Un tabique bien puesto trae un beneficio extra: cuando una llamada falla, la regla culpable se lee en un archivo en vez de adivinarse. Si después quieres observar los flujos de manera continua, mira Cilium y Hubble; en este tutorial me quedo con la API estándar.
Una aclaración: span.observer no ha desplegado estas políticas en ningún clúster. Los manifiestos y comandos proceden de la documentación de Kubernetes, consultada el 8 de noviembre de 2026. Las capturas reproducen esos fragmentos, salidas de prueba incluidas, que son las que anuncia la documentación y no mediciones nuestras.
Qué significa «aislado» para un pod
Todo gira en torno a un interruptor. Mientras ninguna política seleccione a un pod, este queda abierto en ambos sentidos. En cuanto una política lo selecciona para la entrada, solo pasa lo que esa política enumera; con la salida ocurre lo mismo. Antes de escribir una línea de YAML conviene fijar cuatro ideas:
- No existe una regla «denegar». Solo se alarga la lista de permisos, y varias políticas sobre el mismo pod se suman sin orden de prioridad.
- Una conexión necesita el visto bueno de los dos extremos: salida permitida en el origen y entrada permitida en el destino. Las respuestas de una conexión aceptada vuelven sin otra regla.
- El objeto es solo una declaración. Quien bloquea de verdad es el plugin de red (el CNI); si no lo soporta, el objeto existe y no hace nada.
podSelector: {}selecciona todos los pods del espacio de nombres; los interlocutores permitidos se describen por pods, por espacios de nombres o por rangos IP, con puertos opcionales.
Antes de empezar: dónde probar
Usa un clúster desechable. La página de la tarea en la documentación pide kubectl configurado, un servidor 1.8 o superior y un proveedor de red compatible (cita Antrea, Calico, Cilium y Kube-router), preferiblemente con dos nodos de trabajo. No hagas este primer ensayo en producción: un cierre mal pensado también corta servicios que habías olvidado.
NetworkPolicy Kubernetes: cerrar el espacio de nombres
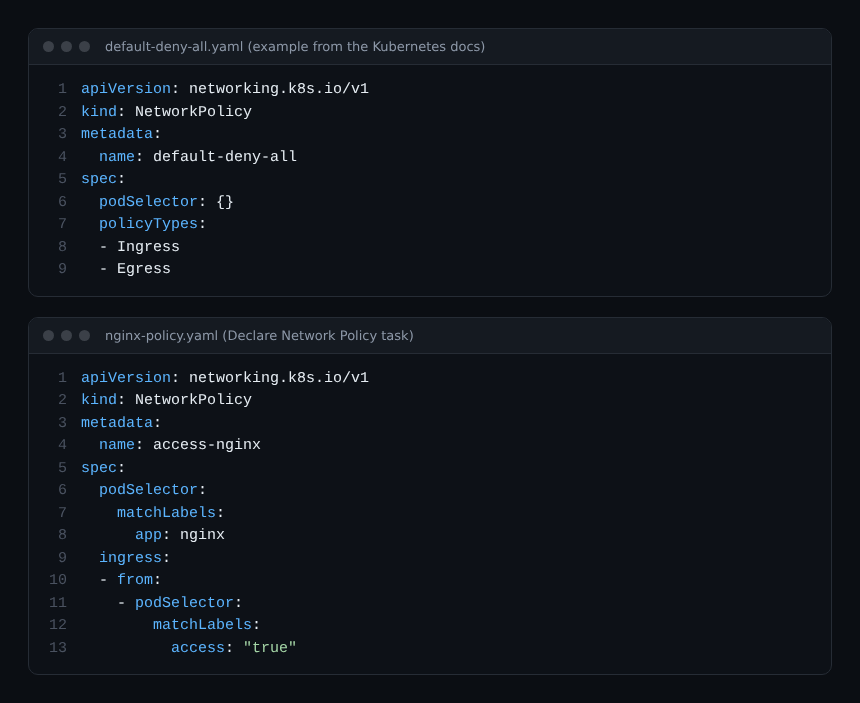
La primera pieza es una política que selecciona todos los pods y no concede ningún permiso. Tras aplicarla, el espacio de nombres no habla con nadie y nadie habla con él.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
spec:
  podSelector: {}
  policyTypes:
  - Ingress
  - Egress
Si quitas Egress de la lista, los pods siguen saliendo sin restricción, y es una forma muy habitual de creerse protegido cuando solo se está a medias. La documentación ofrece también variantes limitadas a la entrada o a la salida, útiles para migrar poco a poco. Avisa a todo el equipo de un detalle: cerrar la salida corta también la resolución de nombres, y volveremos a ello más abajo.
Reabrir un único paso
Como ejemplo, la documentación despliega un nginx expuesto como servicio y solo deja entrar a los pods marcados con access: "true".
kubectl create deployment nginx --image=nginx
kubectl expose deployment nginx --port=80
kubectl apply -f https://k8s.io/examples/service/networking/nginx-policy.yaml
La política access-nginx apunta a los pods app: nginx y acepta como entrada a los pods de su mismo espacio de nombres que lleven esa etiqueta. Aquí van los dos manifiestos juntos: el cerrojo y, después, la puerta entornada.
Comprobar que el tabique aguanta
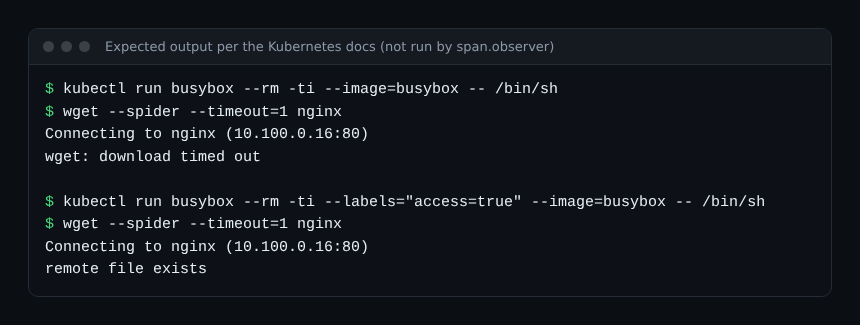
Una regla que no has visto fallar es una regla sin probar. El gesto consiste en lanzar un pod efímero, primero sin la etiqueta y luego con ella, e intentar conectar:
kubectl run busybox --rm -ti --image=busybox -- /bin/sh
wget --spider --timeout=1 nginx

kubectl run busybox --rm -ti --labels="access=true" --image=busybox -- /bin/sh
wget --spider --timeout=1 nginx
El pod sin etiqueta debe acabar en «wget: download timed out» y el otro en «remote file exists». Fíjate en que el bloqueo se manifiesta como silencio, no como un «connection refused» claro. Sin un --timeout corto, la prueba parece simplemente colgada.
Como complemento, tres comandos de revisión: kubectl get networkpolicy -n NAMESPACE para el inventario, kubectl describe networkpolicy NOMBRE para ver cómo se interpretaron los selectores y kubectl get pods --show-labels para confirmar que las etiquetas buscadas existen de verdad.
No esperes que la API te diga qué se ha rechazado: la documentación incluye el registro de eventos de red entre las cosas que NetworkPolicy no hace. Hace falta la herramienta del CNI o una supervisión de red sin sidecar.
Las cuatro maneras de equivocarse
El CNI mudo
El kubectl apply responde «created» y, aun así, todo sigue pasando. Ningún controlador está aplicando el objeto. Nada más instalar, haz una prueba que deba fallar; es la única evidencia que cuenta.
Un guion de más, un guion de menos
En un bloque from, un solo elemento que contiene a la vez namespaceSelector y podSelector expresa una Y: esos pods, en esos espacios de nombres. Dos elementos separados por guiones expresan una O, mucho más amplia: los pods locales indicados, o todos los pods de los espacios de nombres indicados. El YAML es válido en ambos casos, y ahí está el peligro.
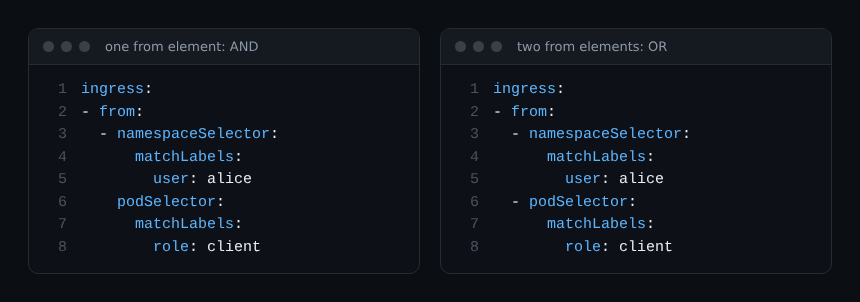
Pods que ya no resuelven nada
Una denegación total de salida bloquea también las consultas DNS. Las aplicaciones empiezan a fallar con nombres y se acaba culpando a la aplicación. Prepara una segunda política que permita la salida hacia el DNS del clúster; su contenido depende de tus etiquetas, por ejemplo kubernetes.io/metadata.name para designar el espacio de nombres que aloja el DNS. No incluyo un manifiesto listo para copiar porque no lo he probado en un clúster.
Pedirle a la API lo que no sabe hacer
No hay TLS, ni pasarela común, ni selección de un servicio por su nombre, ni denegación explícita, ni política por defecto para todos los espacios de nombres. La documentación remite a una malla de servicios o a controladores de admisión. Además, un pod no puede aislarse de su propio nodo, y qué pasa con las conexiones ya abiertas cuando cambias una política depende del plugin.
Mi orden de despliegue
- Un
default-deny-allpor espacio de nombres, aplicado primero y fuera del horario de trabajo. - La regla de DNS justo después, antes de que alguien se queje.
- Una política por flujo, con el nombre del flujo (
allow-frontend-to-api) y versionada en Git. - Para cada regla, una prueba que pase y otra que falle.
- Nada de
ipBlockpara apuntar a pods: la documentación lo reserva para direcciones externas, porque las IP de los pods cambian. - Tras cada cambio, vigila los errores de red con tus alertas de Kubernetes.
Preguntas frecuentes
¿Funciona una NetworkPolicy sin un plugin CNI compatible?
No. El objeto se puede crear, pero sin un plugin que lo implemente no tiene ningún efecto, según la documentación de Kubernetes.
¿Qué ocurre cuando varias políticas seleccionan el mismo pod?
Se suman. No hay conflicto ni orden: la conexión pasa si al menos una política la permite en ese sentido y el otro extremo también la acepta.
¿Hace falta una regla egress para las respuestas?
No, las respuestas a una conexión aceptada vuelven solas. En cambio, toda conexión saliente nueva exige una regla egress en cuanto el pod queda aislado en la salida.
En resumen
Cerrar, abrir un paso cada vez y verificar en los dos sentidos: ese es todo el oficio, y las trampas se cuentan con los dedos de una mano (CNI mudo, guion sobrante, DNS olvidado). Prueba en un clúster de test y extiende después espacio de nombres por espacio de nombres. Referencia: la documentación de Kubernetes sobre NetworkPolicy.
span.observer es un blog independiente de la comunidad, no afiliado a Kubernetes, a la CNCF ni a Dynatrace LLC. Las marcas citadas pertenecen a sus propietarios. Las herramientas cambian rápido: comprueba siempre los comandos y las opciones en su documentación oficial.