Un circuit breaker Elasticsearch es una protección de memoria: cuando una operación amenaza con saturar el heap de la JVM, Elasticsearch la rechaza en lugar de dejar que el nodo caiga por OutOfMemory. El más temido es el breaker padre. Según la documentación de Elastic, rechaza las operaciones cuando se alcanza su límite. Para un equipo SRE, ese rechazo es una señal útil, pero se traduce en errores del lado de los clientes: hay que saber leerlo.
Este artículo muestra cómo reconocer el error, medir la presión de memoria, corregir las causas frecuentes y exportar después las métricas de JVM y de breaker a Dynatrace con OpenTelemetry. El contenido vale para Dynatrace SaaS; los ajustes de Elasticsearch no dependen de Dynatrace.
Circuit breaker Elasticsearch: qué dice el parent breaker
Elasticsearch usa varios breakers. Cada breaker hijo vigila un tipo de consumo (fielddata, consultas, peticiones de red en vuelo) y el breaker padre vigila el conjunto. Según la página de ajustes, estos son los valores por defecto citados:
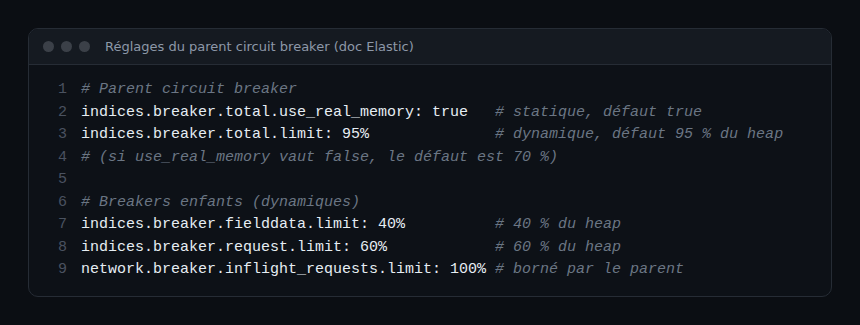
indices.breaker.total.use_real_memory: ajuste estático,truepor defecto. El padre tiene entonces en cuenta el uso real de la memoria, no solo lo que reservan los breakers hijos.indices.breaker.total.limit: ajuste dinámico. Por defecto: 95 % del heap de la JVM siuse_real_memoryvaletrue, 70 % en caso contrario.- Breakers hijos:
fielddataal 40 %,requestal 60 %,inflight_requestsal 100 % (acotado por el límite del padre).
El breaker request cubre las estructuras por consulta, como la memoria de las agregaciones; ES|QL comparte este breaker. Lo más importante: el padre se dispara según la memoria realmente usada del nodo, de modo que un breaker hijo puede seguir bajo su límite mientras el padre bloquea.
Reconocer una CircuitBreakingException
La página de resolución de problemas describe el error: Elasticsearch responde con el estado HTTP 429, el type del error es circuit_breaking_exception y la reason empieza por [parent] Data too large. En el servidor, elasticsearch.log registra una CircuitBreakingException. Este último punto ayuda cuando un proceso automático, como la asignación de shards, dispara el breaker sin que ningún cliente reciba un error.
Un 429 no dice qué consulta causó la saturación: la que falla suele ser solo la última en llegar. Trata el error como un síntoma de presión de memoria, no como un defecto de la consulta rechazada.
Paso 1: medir la presión de memoria del heap
El heap instantáneo oscila en dientes de sierra; la página «high JVM memory pressure» recomienda seguir la presión de memoria de la JVM, una media móvil ligada a la recolección de basura de la generación antigua. El cálculo por nodo es jvm.mem.pools.old.used_in_bytes dividido entre max_in_bytes, multiplicado por 100. La página ofrece un comando jq sobre una respuesta guardada de la API node stats. Este es el principio, con identificadores de ejemplo:
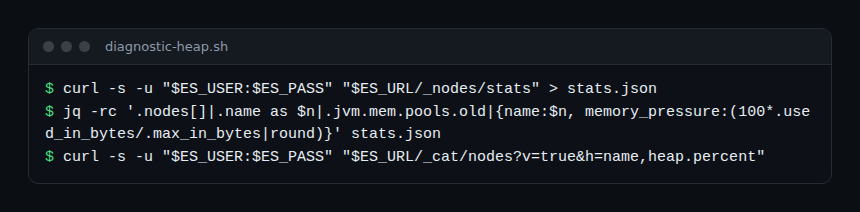
curl -s -u "$ES_USER:$ES_PASS" "$ES_URL/_nodes/stats" > stats.json
jq -rc '.nodes[]|.name as $n|.jvm.mem.pools.old|{name:$n, memory_pressure:(100*.used_in_bytes/.max_in_bytes|round)}' stats.json
Los umbrales citados por Elastic: el breaker padre se dispara por defecto al 95 % de uso de memoria de la JVM, y la documentación aconseja actuar si el uso supera de forma sostenida el 85 %. En Elastic Cloud, los indicadores pasan a rojo al 75 %. El comando _cat/nodes con la columna heap.percent da una visión rápida, pero es un porcentaje instantáneo.
Paso 2: ver qué breaker saltó
La API node stats expone, para cada breaker, el uso estimado, el límite, el número de disparos y el factor de sobrecarga. Compara el contador de disparos del padre con los de los hijos. Según la página de resolución de problemas, a partir de la versión 9.3 una API específica, cat circuit breaker, da una salida tabular por breaker y por nodo. La página no detalla la petición exacta: consulta la referencia de tu versión antes de automatizarla.
Ten presente un límite que reconoce la documentación: los breakers se basan en estimaciones puntuales. Las operaciones en paralelo, las agregaciones, las consultas complejas o la memoria fuera del heap (pilas de hilos) aún pueden provocar un OOM.
Paso 3: corregir las causas frecuentes
Antes de subir un límite, busca la causa. Subir indices.breaker.total.limit desplaza el problema hacia el OOM. Las causas y pistas que enumera Elastic:
- Fielddata en un campo
text: desactivado por defecto. Si lo activaste, usa un campokeyword(multi-field). Si no, la API clear cache vacía la caché, con el riesgo de perturbar las búsquedas en curso que la usan. - Tamaño del heap:
Xmsigual aXmx, y no más de la mitad de la RAM del sistema; verifica los compressed OOPs (jvm.using_compressed_ordinary_object_pointers), que a menudo se pierden por encima de unos 30 GB. - Swap: hay que desactivarlo; controla
os.swap.used_in_bytes. - Demasiados shards o segmentos: cada shard consume memoria; menos shards pero más grandes suelen ser más eficientes. Un force merge tras terminar las escrituras reduce los segmentos.
- Búsquedas costosas: activa los slow logs y luego considera
index.max_result_window,search.max_buckets,search.allow_expensive_queriesosearch.default_search_timeout(la página da 5000, 20000,falsey"1m"como ejemplos, no como valores recomendados). - Bulk y multi-search demasiado grandes: envía peticiones más pequeñas y más espaciadas.
Si el heap sigue alto a pesar de estas correcciones, la documentación sugiere capturar un heap dump mientras la memoria está alta, o aumentar la memoria de los nodos.
Paso 4: exportar las métricas de JVM y de breaker a Dynatrace
El receiver elasticsearch del Collector de OpenTelemetry (distribución contrib, métricas en beta, Elasticsearch 7.9 como mínimo según su README) consulta la API del clúster. Su archivo de métricas enumera, activadas por defecto: elasticsearch.breaker.memory.estimated, elasticsearch.breaker.memory.limit, elasticsearch.breaker.tripped, jvm.memory.heap.used, jvm.memory.heap.max, además de jvm.memory.pool.used y jvm.memory.pool.max. La métrica jvm.memory.heap.utilization existe, pero está desactivada por defecto. Con la seguridad activa, el usuario necesita el privilegio de clúster monitor o manage.
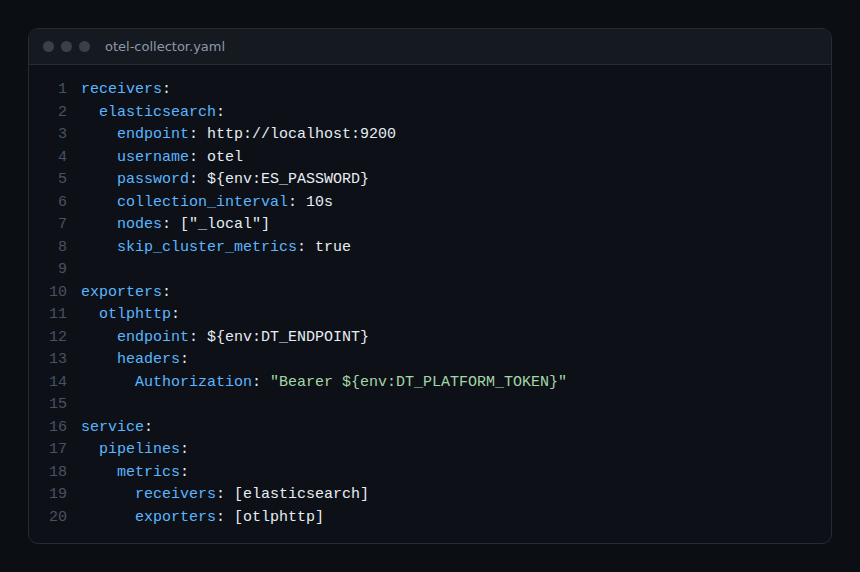
La configuración retoma los parámetros del README (nodes: ["_local"] para un receiver por nodo; skip_cluster_metrics en true evita las métricas de clúster duplicadas). El envío a Dynatrace, el token y el procesador cumulativetodelta se detallan en nuestra guía del Collector a Dynatrace; consulta también el tutorial sobre el receiver elasticsearch. Adapta las variables DT_ENDPOINT y DT_PLATFORM_TOKEN y nunca subas el token a un repositorio.
Cómo comprobar que funciona
- Añade el exporter
debugal pipeline: las métricaselasticsearch.breaker.*yjvm.memory.*deben aparecer en los logs del Collector. - En Dynatrace, busca esos nombres de métricas y construye una serie por nodo; la consulta DQL se describe en el artículo sobre las consultas DQL timeseries.
- Crea una alerta sobre el aumento de
elasticsearch.breaker.trippedy otra sobre el uso del heap cercano al umbral del 85 % citado por Elastic. Añade una alerta de ausencia de datos: un nodo que ya no responde deja de producir puntos.
Qué cambia para un equipo SRE
Un 429 de breaker consume error budget de un SLI de disponibilidad de las búsquedas o de la ingesta. Pon los umbrales sobre la tendencia de la presión de memoria en lugar de sobre el error, para actuar antes del rechazo. Escribe el runbook en modo blameless: la consulta que falla rara vez es la única responsable. Para comparar este enfoque con una solución integrada, consulta la comparativa de Dynatrace y Datadog; para la diferencia entre medir y comprender, consulta observabilidad y monitorización.
Buenas prácticas
- Corrige la causa (fielddata, shards, consultas) antes de modificar un límite de breaker.
- Sigue la presión de memoria de la generación antigua, no solo el heap instantáneo.
- Alerta antes del 95 %: la documentación propone el 85 % como umbral de acción.
- Fija la versión del Collector: el receiver está en beta.
Preguntas frecuentes
¿Cuál es el límite por defecto del breaker padre?
El 95 % del heap de la JVM cuando indices.breaker.total.use_real_memory vale true (el valor por defecto), y el 70 % en caso contrario, según la documentación de Elastic.
¿Hay que aumentar indices.breaker.total.limit?
Raramente. La documentación orienta hacia la reducción de la presión de memoria. Subir el límite deja menos margen antes de un OutOfMemory.
¿Qué código HTTP devuelve un breaker disparado?
Un estado 429, con un error circuit_breaking_exception cuya razón empieza por [parent] Data too large.
Conclusión: el breaker padre protege el nodo, pero revela un heap bajo tensión. Mide la presión de memoria, encuentra la causa y exporta después las métricas por OTLP para recibir una alerta antes del 429.
Fuentes oficiales: ajustes de los circuit breakers, circuit breaker errors, high JVM memory pressure, receiver elasticsearch.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Dynatrace es una marca de Dynatrace LLC. Los nombres de productos pertenecen a sus propietarios; los identificadores y las URL de los ejemplos son ficticios. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.