Módulo 7 del curso de métricas de Dynatrace Managed, dedicado a metric selector y alertas con la API Metrics v2: escribir una consulta de métricas, llamarla con curl, crear las métricas que faltan y disparar después una alerta de Davis cuando se desvíen.
Curso: Formación en métricas de Dynatrace Managed · Módulo 7/7 · Duración: ~75 min · Nivel: intermedio a avanzado
Objetivos:
- Leer el descriptor de una métrica y encadenar las transformaciones del metric selector
- Escribir una expresión aritmética entre métricas y llamar a
/api/v2/metrics/querycon curl - Crear una métrica calculada de servicio, una métrica de logs o una métrica ingerida
- Configurar un metric event: umbral estático, autoadaptativo o baseline estacional
Requisitos previos: los módulos 2 a 6; un token de API con el scope metrics.read, y después WriteConfig, metrics.ingest y settings.write según los pasos; curl, jq y un entorno de pruebas.
Los módulos anteriores mostraron qué métricas mirar. Este muestra cómo consultarlas y cómo convertirlas en una señal de guardia (on-call). El metric selector es el lenguaje común del Data Explorer, de los tiles de dashboard, de los metric events y de la API Metrics v2: la misma cadena de caracteres sirve para trazar una curva, alimentar un SLO y lanzar una alerta.
Este módulo vale para Dynatrace Managed (y para las métricas clásicas de SaaS). No trata DQL ni el comando timeseries de Grail, reservados a Dynatrace SaaS y tratados en el curso de métricas de SaaS.
Metric selector y alertas: la misma sintaxis en todas partes
Un selector empieza por una o varias claves de métricas, seguidas de transformaciones separadas por dos puntos, evaluadas de izquierda a derecha. Cada transformación se aplica al resultado de la anterior.
builtin:host.cpu.usage:sort(value(avg,descending)):limit(10)Dos límites que conviene conocer: un selector contiene al menos una clave, y una consulta interroga como máximo 10 métricas. Para varias métricas de un mismo padre, la documentación permite la forma corta builtin:host.cpu.(usage,idle).
El consejo de la documentación de Dynatrace: construye tus selectors en la pestaña Code del Data Explorer (modo avanzado), que ofrece autocompletado, y cópialos después en la API o en una configuración.
Empezar por el descriptor
Antes de escribir un selector, lee el descriptor de la métrica con GET /api/v2/metrics/{metricId}. Cuentan tres campos: aggregationTypes (las agregaciones posibles), defaultAggregation (la que se aplica si no indicas ninguna) y dimensionDefinitions (las claves de dimensiones utilizables en splitBy y filter).
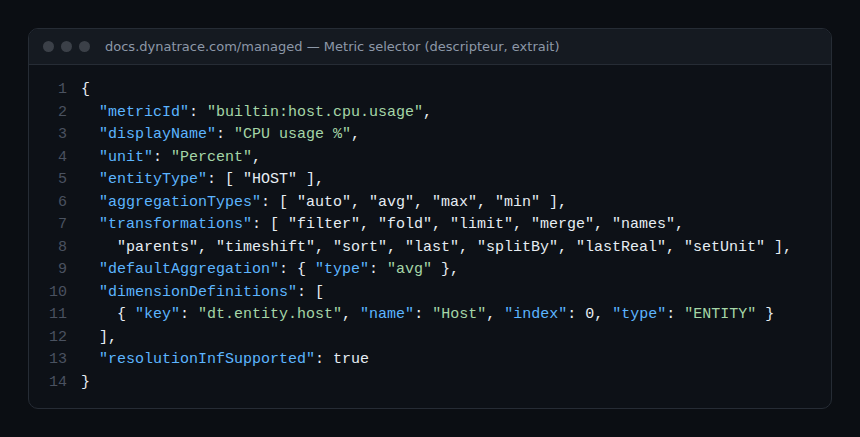
Aquí, builtin:host.cpu.usage se agrega por defecto como media y tiene una sola dimensión, dt.entity.host.
Las transformaciones esenciales
| Transformación | Sintaxis | Efecto |
|---|---|---|
| Agregación | :max, :avg, :percentile(90)… |
Agregación en el tiempo, por intervalo |
| Split by | :splitBy("dim1","dim2") |
Conserva esas dimensiones y fusiona las demás; :splitBy() lo fusiona todo |
| Filter | :filter(eq("dim","valeur")) |
Filtra por una dimensión o por el valor de una serie |
| Fold | :fold(max) |
Reduce cada serie a un solo punto |
| Sort / Limit | :sort(value(avg,descending)):limit(10) |
Top N |
| Default | :default(0) |
Sustituye los valores nulos |
| Rate | :rate(1m) |
Convierte un contador en una tasa |
| Rollup | :rollup(avg,15m) |
Suaviza sobre una ventana deslizante |
| Time shift | :timeshift(-1d) |
Desplaza el periodo (comparación con el día anterior) |
| To unit | :toUnit(<origen>,<destino>) |
Convierte la unidad de los puntos (lista de unidades: GET /api/v2/units) |
Agregación en el tiempo y en el espacio
Sin agregación explícita, la métrica usa su agregación por defecto. Para ver el pico de CPU de cada intervalo en lugar de la media:
builtin:host.cpu.usage:maxPara obtener una sola cifra, el pico de todo el periodo, añade fold:
builtin:host.cpu.usage:fold(max)La agregación en el espacio pasa por splitBy. Sin argumentos, fusiona todos los hosts en una sola serie:
builtin:host.cpu.usage:splitBy()Filtrar por dimensión, por entidad o por valor
El filtro eq compara una dimensión con un valor; in acepta un entity selector, lo que permite filtrar por tag. Las comillas internas se escapan con una tilde:
builtin:host.cpu.usage
  :filter(
    in(
      "dt.entity.host",entitySelector("type(~"HOST~"),tag(~"easyTravel~")")
    )
  )
La condición series filtra por el valor agregado de cada serie: aquí solo se quedan los hosts cuya media supera el 80 %.
builtin:host.cpu.usage:filter(series(avg,gt(80)))Las condiciones se combinan con and, or y not.
Rate, rollup y timeshift exigen una agregación
La documentación impone aplicar una agregación antes de rate, rollup y toUnit. Ejemplo de suavizado a 15 minutos, útil para un gráfico de tendencia:
builtin:host.cpu.usage:avg:rollup(avg,15m)Y la misma métrica desplazada un día, para superponerla a la curva de hoy:
builtin:host.cpu.usage:timeshift(-1d)Expresiones aritméticas entre métricas
El selector acepta las operaciones + - * / entre métricas y números, con paréntesis. Las series se emparejan por tupla de dimensiones y después se alinean por marca de tiempo. El ejemplo de la documentación calcula una tasa de errores de servicio:
builtin:service.errors.total.count:value:default(0)
/
(
    builtin:service.errors.total.successCount:value:default(0)
    +
    builtin:service.errors.total.count:value:default(0)
)
El default(0) evita que un intervalo sin errores anule todo el ratio. Dos reglas de la documentación: aplica limit al resultado de la expresión, nunca a los operandos, y no uses una expresión para convertir una unidad (prefiere toUnit).
Llamar a la API Metrics v2 con curl
En Managed, el endpoint es https://{votre-domaine}/e/{id-environnement}/api/v2/metrics/query (o a través de un ActiveGate, puerto 9999 por defecto). Exige el scope metrics.read.
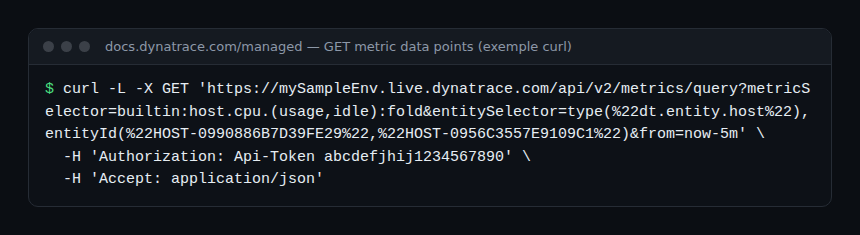
Adaptado a un clúster Managed, con curl codificando los parámetros:
export DT_ENV="https://dynatrace.example.com/e/votre-id-environnement"
curl -sS -G "$DT_ENV/api/v2/metrics/query" \
  -H "Authorization: Api-Token $DT_TOKEN" \
  --data-urlencode 'metricSelector=builtin:host.cpu.usage:sort(value(avg,descending)):limit(5)' \
  --data-urlencode 'from=now-24h' \
  --data-urlencode 'resolution=1h' \
  | jq '.result[0].data[] | {host: .dimensionMap["dt.entity.host"], last: .values[-1]}'
Los parámetros que debes conocer:
resolution: por defecto 120 puntos; una duración (10m,1h) oInfpara un solo punto. La resolución más fina es el minuto, y depende también de la antigüedad de los datos.from/to: marca de tiempo, fecha ISO o relativo (now-2h, valor por defecto defrom).entitySelector: restringe a las entidades elegidas, por ejemplotype("HOST"),tag("prod").mzSelector: restringe a una management zone, por ejemplomzName("Paiement").- Cabecera
Accept: text/csv; header=present: respuesta en CSV en lugar de JSON.
La lista completa de endpoints de Managed está en API de Dynatrace Managed: endpoints y esquemas, y la automatización más general en el módulo 8 del curso de Managed.
Crear las métricas que faltan
Las métricas integradas cubren lo esencial, pero no todo: el tiempo de respuesta de un solo endpoint de pago, el número de pedidos rechazados leído en un log, la profundidad de una cola interna. Tres mecanismos cubren esos huecos: métricas calculadas de servicio (calc:service.), métricas de logs (log.) e ingesta de métricas.
Estas métricas son métricas personalizadas: a diferencia de las integradas, consumen Davis data units (DDU). Créalas para una necesidad concreta, no por reflejo.
Crear una métrica calculada de servicio
Una métrica calculada de servicio aplica condiciones a las peticiones de un servicio (tag, ruta de URL, atributo de petición…) y mide un valor: REQUEST_COUNT, RESPONSE_TIME, FAILURE_RATE, ERROR_COUNT, CPU_TIME, etc. Puede desglosarse por una dimensión, limitada a los N valores principales.
La API de configuración la crea con POST /api/config/v1/calculatedMetrics/service (scope WriteConfig). El ejemplo de la documentación cuenta las peticiones de los servicios con el tag payment, por clase de estado HTTP:
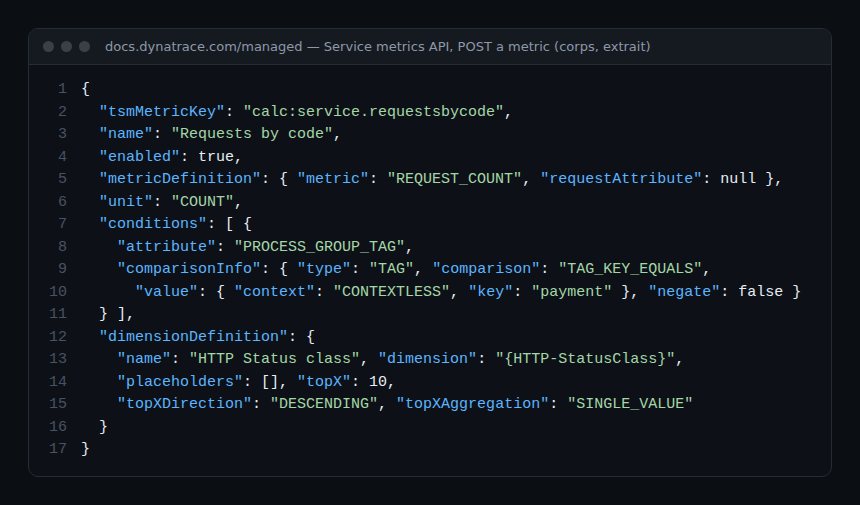
curl -sS -X POST "$DT_ENV/api/config/v1/calculatedMetrics/service" \
  -H "Authorization: Api-Token $DT_TOKEN" \
  -H "Content-Type: application/json; charset=utf-8" \
  -d @requestsbycode.json
# réponse attendue (201) : {"id":"calc:service.requestsbycode","name":"Requests by code"}
Puntos de atención:
tsmMetricKeyempieza obligatoriamente porcalc:service.; es la clave que se usará después en el metric selector.dimensionDefinitioncontopXlimita el número de valores de dimensión conservados: un desglose por URL completa dispararía la cardinalidad.- La métrica no tiene histórico: empieza a llenarse en el momento de su creación.
Una vez creada, se consulta como las demás: calc:service.requestsbycode:splitBy("dt.entity.service"):sum, por ejemplo, que debes adaptar a las dimensiones de su descriptor.
Extraer una métrica de logs
En Log Monitoring Classic, una métrica de logs se crea en Settings > Log Monitoring > Metrics extraction, con Add log metric, o desde el log viewer con Create metric. Su clave siempre empieza por log.. Eliges:
- un Matcher: la consulta de log que selecciona las líneas;
- una medida: Occurrence of log records (número de líneas) o Attribute value (valor numérico de un atributo);
- dimensiones opcionales, tomadas de los atributos del log.
Ejemplo típico: log.payment.refused, que cuenta las líneas que contienen el código de rechazo de un proveedor de pagos, desglosado por proveedor. Dos límites: la métrica solo existe a partir de los logs ingeridos tras su creación, y la documentación fija un tope de 1 000 000 de valores de dimensión por métrica. Elige dimensiones de baja cardinalidad. Cambiar la clave crea una métrica nueva: el histórico se queda bajo la antigua.
Ingerir tus propias métricas
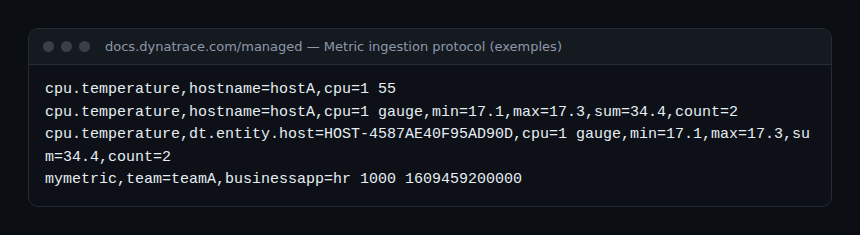
Para una medida que ningún agente ve (tamaño de una cola, resultado de un batch, una cifra de negocio), envía puntos a POST /api/v2/metrics/ingest (scope metrics.ingest), en el formato de texto del protocolo de ingesta. Una línea = un punto:
curl -sS -X POST "$DT_ENV/api/v2/metrics/ingest" \
  -H "Authorization: Api-Token $DT_TOKEN" \
  -H "Content-Type: text/plain; charset=utf-8" \
  --data-binary 'batchjob.duration,job=facturation,dt.entity.host=HOST-4587AE40F95AD90D gauge,412'
# réponse attendue (202) : "linesOk": 1, "linesInvalid": 0
Las reglas del protocolo que debes recordar:
- Gauge por defecto; el formato
count,delta=…crea una métrica con el sufijo.count. - 50 dimensiones como máximo;
dt.entity.host(y las demásdt.entity.*) vincula el punto a una entidad y, por tanto, las alertas a esa entidad. - Marca de tiempo en milisegundos UTC, aceptada desde una hora en el pasado hasta diez minutos en el futuro.
- Prefijo
dt.prohibido, reservado a Dynatrace; carga útil limitada a 1 MB por petición. - Desde un host monitorizado, OneAgent expone también un endpoint local (
http://localhost:14499/metrics/ingestpor defecto) que no requiere token.
Metric selector y alertas: los metric events
Un metric event convierte cualquier métrica, integrada o personalizada, en un evento de Davis y, por tanto, en un problema y una notificación. Se configura en Settings > Anomaly detection > Metric events, o por la API Settings con el esquema builtin:anomaly-detection.metric-events.
- Tipo de consulta:
METRIC_KEY(una clave, solo umbral estático) oMETRIC_SELECTOR(un selector completo, expresiones incluidas). - Modelo:
STATIC_THRESHOLD,AUTO_ADAPTIVE_THRESHOLDoSEASONAL_BASELINE; los dos últimos exigen un metric selector. - Ventana deslizante:
samplesmuestras de un minuto, de las cualesviolatingSamplesdeben violar el umbral para abrir el evento, ydealertingSamplesvolver a la normalidad para cerrarlo. - Datos ausentes:
alertOnNoData; la documentación aconseja desactivarlo para las series dispersas.
Ejemplo: alertar cuando la tasa de fallos de un servicio con el tag payment supera el 5 % durante 3 minutos de cada 5. El cuerpo sigue los campos del esquema; compruébalos en tu versión con GET /api/v2/settings/schemas/builtin:anomaly-detection.metric-events.
[{
  "schemaId": "builtin:anomaly-detection.metric-events",
  "scope": "environment",
  "value": {
    "enabled": true,
    "summary": "Taux d'échec paiement > 5 %",
    "queryDefinition": {
      "type": "METRIC_SELECTOR",
      "metricSelector": "builtin:service.errors.total.rate:filter(in(\"dt.entity.service\",entitySelector(\"type(~\"SERVICE~\"),tag(~\"payment~\")\"))):splitBy(\"dt.entity.service\"):avg"
    },
    "modelProperties": {
      "type": "STATIC_THRESHOLD",
      "threshold": 5,
      "alertCondition": "ABOVE",
      "alertOnNoData": false,
      "samples": 5,
      "violatingSamples": 3,
      "dealertingSamples": 5
    },
    "eventTemplate": {
      "title": "Taux d'échec paiement élevé",
      "description": "Le taux d'échec dépasse 5 %.",
      "eventType": "ERROR",
      "davisMerge": true
    }
  }
}]
Envíalo con POST /api/v2/settings/objects (scope settings.write). El enrutado de las notificaciones posteriores corresponde a los perfiles de alertas: consulta Alertas, perfiles e integraciones en Managed y, para evitar la avalancha, Reducir el ruido de las alertas de Davis.
Ejercicio práctico
Paso 1 — Leer un descriptor
curl -sS "$DT_ENV/api/v2/metrics/builtin:host.disk.avail" \
  -H "Authorization: Api-Token $DT_TOKEN" | jq '.dimensionDefinitions[].key'
Resultado esperado: dt.entity.host y dt.entity.disk.
Paso 2 — Construir un top 5 en el Data Explorer
En la pestaña Code, escribe un selector que muestre los cinco hosts con la CPU media más alta durante 24 horas y añade después una segunda consulta con :timeshift(-1d). Resultado esperado: dos curvas superpuestas sobre el mismo periodo.
Paso 3 — Ingerir una métrica y encontrarla
Envía cinco puntos de batchjob.duration con un minuto de intervalo usando el comando de ingesta anterior y escribe después batchjob.duration:splitBy("job"):max en el Data Explorer. Resultado esperado: "linesOk": 1 en cada envío y, después, una serie facturation con tus cinco valores.
Paso 4 — Un metric event de prueba
Crea un metric event de umbral estático sobre esa métrica, con un umbral inferior a tus valores. Resultado esperado: un problema abierto sobre el host referenciado por dt.entity.host.
Paso 5 — Cómo comprobar que funciona
La respuesta de /api/v2/metrics/query debe contener "totalCount" y un array result; un código 403 indica un scope ausente, un 400 un error de sintaxis descrito en el mensaje. Abre después el problema: el evento lleva el título de tu eventTemplate. En Settings > Anomaly detection > Metric events, la vista general señala también las configuraciones fallidas (QUERY_FAILED, THROTTLED) de las últimas 24 horas. Elimina por último el evento de prueba.
Buenas prácticas
- Prototipa en el Data Explorer y copia después el selector en el script, el dashboard o el metric event.
- Filtra pronto y usa siempre
sortantes delimit: menos series leídas y un top N con sentido. - Una métrica personalizada por pregunta, no por curiosidad: cada una consume DDU.
- Cardinalidad controlada:
topXpara las métricas calculadas, dimensiones de valores limitados para los logs y la ingesta. - Varias muestras en violación en lugar de una sola, y alerta sobre el síntoma (tasa de fallos, latencia): menos falsos positivos, menos fatiga de guardia.
- Versiona tus selectors junto con los dashboards y las alertas: son tus SLI.
Cuestionario
- ¿Qué devuelve
builtin:host.cpu.usage:fold(max)? a) Una serie por minuto b) Un punto por serie: el máximo del periodo c) La media de todos los hosts d) Un error - ¿Qué hace
:splitBy()sin argumentos? a) Nada b) Fusiona todas las dimensiones en una serie c) Desglosa por todas las dimensiones d) Elimina los valores nulos - ¿Qué scope hace falta para
/api/v2/metrics/query? a)ReadConfigb)metrics.ingestc)metrics.readd)entities.read - ¿Con qué prefijo empieza una métrica calculada de servicio? a)
builtin:b)calc:service.c)log.d)ext: - ¿Qué prefijo está prohibido en la ingesta? a)
custom.b)app.c)dt.d) ninguno - ¿Qué significa
violatingSamples: 3consamples: 5? a) 3 alertas en 5 días b) 3 minutos en violación en una ventana de 5 minutos abren el evento c) 3 % de tolerancia d) 5 reintentos
Soluciones
- b)
foldreduce la serie a un solo punto con la agregación pedida. - b) Todas las series se fusionan.
- c)
metrics.read. - b)
calc:service.. - c)
dt.está reservado a Dynatrace. - b) Las muestras duran un minuto.
Para ir más lejos
- Dashboard de Dynatrace Managed: tiles, Data Explorer y JSON
- SLO de Dynatrace Managed: configuración y API, donde los SLI son metric selectors
- Davis, problemas y alertas en Managed
- Metric selector (documentación de Dynatrace Managed)
- Metric ingestion protocol (documentación de Dynatrace Managed)
← Módulo 6: cloud y extensiones · Índice del curso · Fin del curso
Preguntas frecuentes
¿Por qué mi consulta devuelve menos puntos de los pedidos?
La resolución es un valor de referencia: Dynatrace la ajusta según el periodo y la antigüedad de los datos. Los datos antiguos ya no están disponibles al minuto.
¿Recupera el histórico una métrica calculada?
No. Se llena a partir de su creación. Si necesitas el pasado, analiza las trazas existentes en el análisis multidimensional del servicio y crea después la métrica para lo que venga.
¿Metric event o detección automática de anomalías de Davis?
Las dos se complementan. Davis ya vigila servicios, aplicaciones e infraestructura con sus referencias automáticas. El metric event sirve para las métricas que Davis no vigila por sí solo: métricas calculadas, de logs o ingeridas, o un umbral contractual preciso.
Has terminado el curso: sabes leer una clave de métrica, elegir la adecuada para un host, un servicio, una aplicación, un proceso o un recurso cloud, consultarla con un selector y por la API, y crear y vigilar tus propias métricas. Ten el índice a mano como recordatorio.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC. Dynatrace es una marca de Dynatrace LLC. Este curso no sustituye las formaciones y certificaciones oficiales de Dynatrace University. Comprueba siempre las claves de métricas y las funcionalidades en la documentación oficial correspondiente a tu versión.