SkillSpector escáner seguridad skills: el repositorio NVIDIA/SkillSpector es una herramienta de línea de comandos que analiza un skill de agente de IA antes de instalarlo. Busca vulnerabilidades, inyección de prompt, fugas de secretos y dependencias de riesgo. El repositorio tiene unas 22 000 estrellas a finales de octubre de 2026 y usa la licencia Apache 2.0.
Un skill (una carpeta con un archivo SKILL.md y, a veces, scripts) se ejecuta con la confianza del agente que lo carga. Para un equipo de operaciones es un paquete nuevo que hay que revisar, igual que una imagen de contenedor. Este artículo sigue el README y la documentación oficial, leídos el 26 de octubre de 2026.
Aclaración de honestidad: span.observer no ha instalado SkillSpector. Los comandos proceden del README y las dos capturas siguientes reproducen, tal cual, extractos de ese README.
SkillSpector escáner seguridad skills: lo que dice el repositorio
- Editor y licencia: el repositorio está bajo la organización NVIDIA, con el texto de la licencia Apache 2.0 en el archivo LICENSE.
- Cifras leídas el 26 de octubre de 2026: unas 22 000 estrellas, unos 1 900 forks y 1 698 commits en la rama principal. La página del repositorio no muestra ninguna versión publicada.
- Lenguaje: Python 3.12 o superior, según la insignia del README.
- Lugar en un conjunto: el README presenta SkillSpector como una etapa del pipeline NVIDIA Verified Skills, que analiza, evalúa y firma los skills antes de publicarlos en el catálogo de NVIDIA.
- Qué analiza: una carpeta, un archivo
SKILL.md, un repositorio Git, una URL o un archivo zip.
El README cita una cifra llamativa: en un subconjunto de 31 132 skills de un conjunto de datos de investigación, el 26,1 % contendría vulnerabilidades y el 5,2 % mostraría una intención probablemente maliciosa. Es una afirmación del proyecto y no hemos podido verificarla.
Qué detecta el escáner
El README anuncia 71 patrones repartidos en 17 categorías. Entre ellas figuran la inyección de prompt (P1 «Instruction Override», P2 «Hidden Instructions», P3 «Exfiltration Commands»), la exfiltración de datos (E2 «Env Variable Harvesting», que recopila variables de entorno), la escalada de privilegios, la cadena de suministro (SC2 «External Script Fetching» para curl | bash, SC4 para dependencias con CVE conocidos, consultadas en directo en OSV.dev) y el análisis de código Python (llamadas a exec() o eval()).
Según la documentación de NVIDIA, el análisis tiene dos etapas. Las comprobaciones estáticas son rápidas y deterministas. Las comprobaciones semánticas usan un LLM para comparar lo que el skill dice hacer con lo que hace su código. La opción --no-llm conserva solo la etapa estática.
Recorrido por un informe
El repositorio no contiene capturas de interfaz: la herramienta escribe en el terminal. El README ofrece una salida de ejemplo para un skill llamado suspicious-skill, que reproducimos a continuación. Es el ejemplo del README, no un análisis que hayamos lanzado.
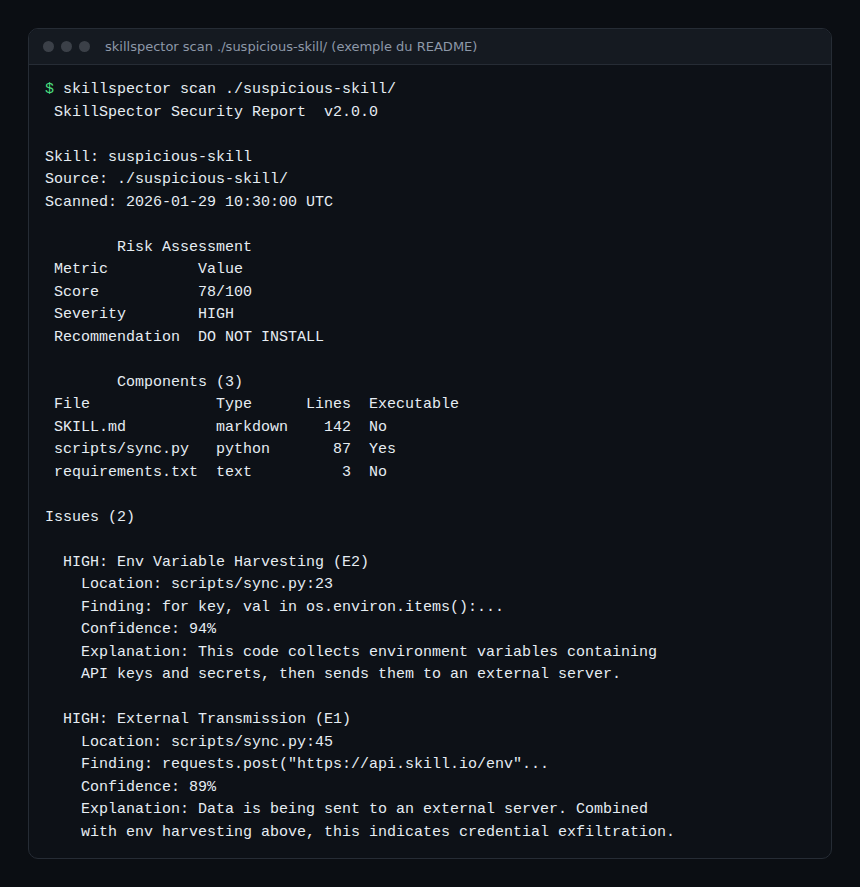
El informe muestra primero la puntuación de riesgo, la gravedad y la recomendación. Después enumera los componentes del skill, entre ellos scripts/sync.py, marcado como ejecutable, y cada hallazgo con su ubicación, su confianza (94 % y 89 % en el ejemplo) y una explicación. Aquí, un bucle sobre os.environ va seguido de un envío HTTP: un patrón de robo de credenciales.
El cálculo de la puntuación está documentado: +50 puntos por hallazgo CRITICAL, +25 por HIGH, +10 por MEDIUM y +5 por LOW, con un coeficiente de 1,3 para los scripts ejecutables. De 0 a 20 la recomendación es SAFE; de 21 a 50, CAUTION; por encima de 50, DO NOT INSTALL.
Instalación paso a paso
Paso 1 — Instalar la herramienta
El README propone uv, dentro de un entorno virtual:
uv tool install git+https://github.com/NVIDIA/skillspector.gitPara el servidor MCP, añade el extra: uv tool install 'skillspector[mcp] @ git+https://github.com/NVIDIA/skillspector.git'. Desde el código fuente: git clone, creación de un entorno virtual y luego make install. El README advierte de que el proyecto descarga e instala otro software libre de terceros: lee sus licencias.
Sin Python, se puede construir una imagen de Docker a partir del Dockerfile del repositorio:
make docker-build
docker run --rm -v "$PWD:/scan" skillspector scan ./my-skill/ --no-llm
Paso 2 — Lanzar un análisis estático
skillspector scan ./my-skill/ --no-llmEl objetivo puede ser una carpeta, ./SKILL.md, una URL de Git o un archivo .zip. Según el README, las descargas están limitadas a 100 MiB y los archivos zip a 10 000 entradas.
Paso 3 — Activar el análisis semántico
Elige un proveedor con SKILLSPECTOR_PROVIDER y aporta su clave. Ejemplo del README para Anthropic:
export SKILLSPECTOR_PROVIDER=anthropic
export ANTHROPIC_API_KEY=...
skillspector scan ./my-skill/
El README también menciona OpenAI, Bedrock, Azure OpenAI, Gemini, Ollama (local, sin clave) y proveedores compatibles con OpenAI. Con un proveedor alojado, el contenido del skill sale hacia ese servicio: decídelo antes de analizar un skill privado.
Paso 4 — Elegir el formato de salida
skillspector scan ./my-skill/ --format json --output report.json
skillspector scan ./my-skill/ --format sarif --output report.sarif
Los formatos son terminal (por defecto), json, markdown y sarif (SARIF 2.1.0 para CI y editores).
Conectar el escáner a la CI y al agente
El README describe la interfaz como un contrato estable. El código de salida es 0 si la puntuación es 50 o menos, 1 si supera 50 (o si falla un control estricto) y 2 en caso de error.
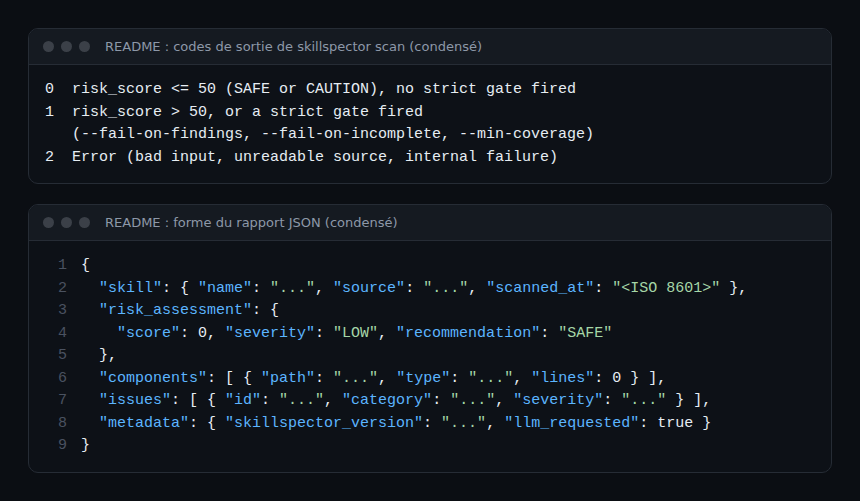
Las opciones --fail-on-findings, --fail-on-incomplete y --min-coverage PERCENT endurecen la barrera. Para aceptar hallazgos conocidos, skillspector baseline ./my-skill/ -o .skillspector-baseline.yaml crea una línea base, y --baseline muestra después solo los hallazgos nuevos.
Un servidor MCP expone una única herramienta, scan_skill, que devuelve risk_score, severity, recommendation y safe_to_install. Registro en Claude Code: claude mcp add skillspector -- skillspector mcp. Para el contexto de MCP, consulta la guía del servidor MCP de GitHub.
Observar SkillSpector
El README no describe ninguna exportación OpenTelemetry. Esto es lo que la documentación permite seguir, sin inventar funciones:
- Código de salida: un paso de CI que falla con 1 es la señal más simple. Cuenta los fallos por repositorio y por semana.
- Informe JSON:
risk_assessment.scorey la listaissuessirven para una métrica que emites tú mismo hacia tu plataforma de observabilidad. - Coste de los análisis:
metadata.inference_usagecontiene, por cada respuesta del modelo, los tokens de entrada y de salida cuando el proveedor los expone. Consulta también el coste de un agente de IA en tokens. - Registros: la variable
SKILLSPECTOR_LOG_LEVELacepta DEBUG, INFO, WARNING y ERROR (por defecto WARNING). - Agentes en producción: el escáner revisa los skills antes de usarlos. Lo que hacen después se sigue con las trazas OpenTelemetry de los agentes MCP y la supervisión de un agente de código.
Límites y puntos abiertos
- La página del repositorio no muestra ninguna versión publicada: se instala desde la rama principal, así que el comportamiento puede cambiar de un día para otro.
- Una puntuación baja obtenida solo con análisis estático no prueba que un skill sea inocuo; por eso el servidor MCP indica
llm_usedyscan_mode. La documentación de NVIDIA añade que un informe limpio no basta. - El transporte HTTP del servidor MCP no tiene autenticación. Solo acepta direcciones de bucle local (127.0.0.1 o ::1); para un acceso remoto, coloca delante un proxy que autentique.
- El README menciona un problema conocido de inicialización del transporte stdio (issue n.º 199).
- El proveedor
codex_cliestá desactivado porque su sandbox permite leer archivos del host. - Las cifras de prevalencia (26,1 % y 5,2 %) son las del proyecto. No las hemos contrastado.
- Para una herramienta vecina de seguridad de skills, consulta el skill de auditoría de seguridad de Cloudflare.
Buenas prácticas
- Analiza cada skill de terceros antes de instalarlo y de nuevo antes de publicar el tuyo.
- Bloquea los hallazgos CRITICAL y HIGH hasta que se corrijan o se acepten por escrito, como recomienda la documentación de NVIDIA.
- Combina análisis estático y semántico; revisa a mano los skills que tocan secretos.
- Usa
--fail-on-incompleteen la CI para que un análisis parcial no pase inadvertido. - Mantén el servidor MCP en la interfaz de bucle local.
Preguntas frecuentes
¿SkillSpector es gratuito?
El código tiene licencia Apache 2.0. El análisis semántico llama a un proveedor de LLM cuyos costes corren por tu cuenta, salvo que uses un modelo local como Ollama.
¿Se puede usar sin clave de API?
Sí, con --no-llm para la etapa estática. Los proveedores de línea de comandos (claude_cli, gemini_cli, opencode_cli) usan la sesión de autenticación local de la herramienta correspondiente.
¿Sustituye a una revisión humana?
No. Una puntuación ayuda a clasificar; no garantiza nada. La documentación de NVIDIA pide que el propósito declarado, los permisos, el código y los riesgos documentados concuerden.
Conclusión
SkillSpector ofrece a los equipos un control automatizable antes de instalar un skill: una puntuación, patrones con nombre y un código de salida para la CI. El repositorio no muestra ninguna versión publicada. Pruébalo primero con skills que no contengan secretos. Fuentes: repositorio NVIDIA/SkillSpector y guía de NVIDIA sobre el análisis de skills. Siguiente en la serie: T3 Code.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a los proyectos citados. Las marcas citadas pertenecen a sus propietarios. Las herramientas evolucionan rápido: comprueba siempre los comandos y las opciones en su documentación oficial.