Las métricas de traza Datadog dan el caudal, los errores y la latencia de un servicio sin que tengas que conservar todas las trazas. Son la base de un dashboard RED (Rate, Errors, Duration) y de alertas fiables. Según la documentación de Datadog, se «calculan sobre el 100 % del tráfico de la aplicación», sea cual sea la configuración de muestreo de la ingesta de trazas.
Esa promesa tiene excepciones, sobre todo cuando se mezclan OpenTelemetry y muestreo. Esta guía describe lo que dice la documentación, la lista de métricas y los casos en que la cifra deja de ser exacta. Va dirigida a equipos SRE y de plataforma que quieren un SLI de latencia o de errores que no dependa de la tasa de conservación de trazas.
Alcance: contenido de Datadog, verificado en la documentación oficial consultada el 30 de octubre de 2026. span.observer no ha realizado ninguna medición.
Métricas de traza Datadog: lo que garantiza la documentación
La página «Trace Metrics» explica que estas métricas son métricas de APM producidas a partir del tráfico de las aplicaciones instrumentadas: número de solicitudes, número de errores, latencia. Por defecto, las calcula el Agent de Datadog a partir de las trazas que la aplicación le envía. Por tanto, primero hay que activar la recolección de trazas e instrumentar la aplicación. Después se usan en dashboards y monitors.
Se generan para los spans de entrada de servicio y para algunas operaciones, según el lenguaje de la integración. El punto clave: el cálculo precede a la decisión de conservar o no una traza. La página sobre los mecanismos de ingesta lo confirma al hablar de métricas «basadas en el 100 % del tráfico». También recuerda que el muestreo en cabecera (head-based) decide en la raíz y luego propaga la decisión: la traza se conserva o se descarta entera.
Para un SRE, la consecuencia es simple. Puedes reducir el volumen de trazas conservadas, y con ello la factura de ingesta, sin falsear la tasa de errores de un SLO. Las trazas sirven para el diagnóstico y las métricas para el control. Esta separación enlaza con la distinción entre observabilidad y monitorización.
Las métricas disponibles para un RED
Los nombres siguen el patrón trace.<SPAN_NAME>.<SUFFIXE>. Esta es la lista de la página «Trace Metrics Namespace».
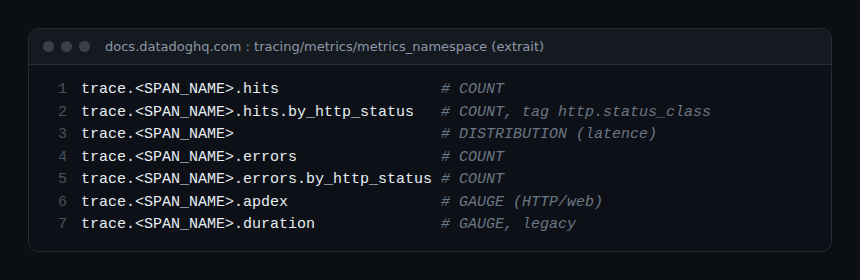
| Necesidad RED | Métrica | Tipo (según la doc) |
|---|---|---|
| Rate | trace.<SPAN_NAME>.hits |
COUNT |
| Errors | trace.<SPAN_NAME>.errors |
COUNT |
| Duration | trace.<SPAN_NAME> |
DISTRIBUTION |
| Detalle HTTP | hits.by_http_status, errors.by_http_status |
COUNT |
| Puntuación Apdex | trace.<SPAN_NAME>.apdex |
GAUGE (servicios HTTP o web) |
Para la latencia, la documentación recomienda la distribución, que admite percentiles. Las métricas duration se consideran legacy, se conservan por compatibilidad y no admiten agregaciones por percentiles. Entre los tags disponibles están env, service, version, resource, http.status_code y http.status_class. Los demás tags de span no están disponibles en estas métricas: para filtrar por un atributo de negocio hace falta otro enfoque, por ejemplo métricas basadas en spans.
Construir un RED paso a paso
- Verificar la recolección. La aplicación está instrumentada y envía sus trazas al Agent (o al Collector, ver más abajo).
- Localizar el nombre de la operación. El
<SPAN_NAME>depende de la integración. Búscalo en el Metrics Summary en lugar de adivinarlo. - Crear el Rate. Representa
trace.<SPAN_NAME>.hitsagrupado porserviceyenv. - Crear los Errors. Divide
errorsentrehitspara obtener una tasa, base de un SLI de disponibilidad. - Crear la Duration. Usa la distribución para los percentiles (p95, p99), no las métricas
duration. - Conectar los monitors a estas series, no al recuento de trazas indexadas.
Cómo comprobar que funciona: reduce temporalmente la conservación de trazas en un entorno de pruebas y compara hits con el número de solicitudes que ve el balanceador de carga. Si la diferencia es pequeña mientras la ingesta baja, el comportamiento documentado se cumple. Si la diferencia es grande, pasa a la sección siguiente.
Cuándo las cifras dejan de ser exactas
La misma página enumera reservas que conviene conocer antes de fiarse de un RED.
- Muestreo en la aplicación. Algunos SDK (la documentación cita Ruby) pueden muestrear los spans antes del Agent, lo que hace que las métricas sean inexactas. Precisa que pocos SDK lo permiten y que, por lo general, no se recomienda.
- SDK de OpenTelemetry. Si el SDK muestrea, las métricas de traza están «muestreadas y potencialmente son inexactas».
- AWS X-Ray. Los spans se muestrean antes de enviarse a Datadog: las métricas pueden no reflejar todo el tráfico.
- Single span sampling. Las reglas sobre un único span pueden conservar spans que un muestreo en cabecera habría descartado, pero no descartar spans conservados.
Es decir, la garantía se mantiene mientras nada anterior al Agent elimine spans.
Con OpenTelemetry: calcular antes de muestrear
Si pasas por un Collector de OpenTelemetry, el orden de los componentes decide la exactitud. Para calcular las métricas sobre todo el tráfico y muestrear en el Collector, la documentación de Datadog indica colocar el connector span_metrics antes de los procesadores de muestreo como tail_sampling. El README del Datadog connector (repositorio OpenTelemetry Collector contrib) dice lo mismo para su componente: deriva estadísticas de APM a partir de las trazas y debe colocarse antes, «para que las métricas se calculen antes del muestreo».
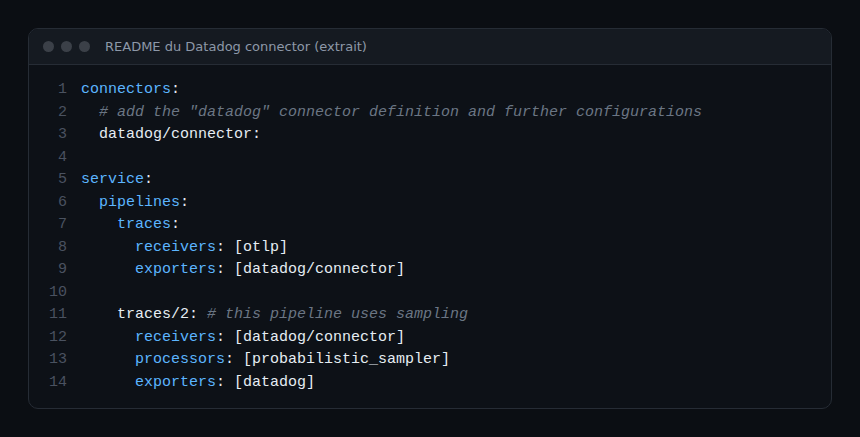
En este extracto, el primer pipeline recibe OTLP y alimenta el connector. El segundo, el que muestrea, recibe después las trazas del connector. Así, el connector ve el flujo completo. El mismo principio vale para cualquier cadena de OpenTelemetry: consulta nuestra guía sobre el tail sampling con OpenTelemetry y la del Collector de OpenTelemetry en Kubernetes. El razonamiento (calcular las métricas antes de descartar trazas) no depende del proveedor; aquí no afirmamos que un connector de Datadog se aplique tal cual a Dynatrace.
Buenas prácticas
- Basa tus SLO y tus alertas en las métricas de traza, nunca en el número de trazas conservadas.
- Mantén un único lugar donde se decida el muestreo y documéntalo.
- Usa la distribución de latencia, no las métricas
durationlegacy. - En un Collector, calcula las métricas antes de cualquier procesador de muestreo.
- Controla con regularidad la diferencia con una fuente independiente (balanceador, pasarela).
Para situar Datadog frente a otras plataformas, consulta la comparativa entre Dynatrace y Datadog.
Preguntas frecuentes
¿Las métricas de traza Datadog se calculan sobre todas las solicitudes?
Según la documentación de Datadog, sí: se basan en el 100 % del tráfico, con independencia del muestreo de la ingesta. Las excepciones son el muestreo en el SDK o en X-Ray, antes del Agent.
¿Qué métrica usar para los percentiles de latencia?
La distribución trace.<SPAN_NAME>. Las métricas duration son legacy y no admiten percentiles.
¿Cómo mantener métricas exactas con un Collector de OpenTelemetry?
Coloca el connector que calcula las métricas (span_metrics o el Datadog connector) antes de los procesadores de muestreo, como indican la documentación de Datadog y el README del connector.
Conclusión
Las métricas de traza Datadog permiten separar el control (RED, SLO) del almacenamiento de trazas, siempre que ningún muestreo intervenga antes de su cálculo. Revisa tu cadena, del SDK al Agent o al Collector, y compara con una fuente independiente. Referencias oficiales: Trace Metrics, Metrics Namespace, Ingestion Mechanisms y Datadog connector.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Datadog Inc. Datadog es una marca de su propietario. La información procede de la documentación oficial consultada el 30 de octubre de 2026: compruébala para tu versión.