El coste de Elastic Observability Serverless depende solo de dos volúmenes: lo que envías cada mes al proyecto y lo que conservas en él. Para un equipo de SRE o de plataforma, el trabajo consiste en estimar esos dos números antes de conectar las fuentes y vigilarlos después. Este artículo da el método, las cifras leídas en la documentación de Elastic y un cálculo de ejemplo que puedes rehacer con tus propios volúmenes.
Aquí ningún precio procede de un sitio de terceros. Las tarifas citadas se leyeron en la página oficial de Elastic el 30 de octubre de 2026 y pueden cambiar: vuelve a leerlas antes de elaborar cualquier presupuesto.
En resumen
- Dos dimensiones de volumen: la ingesta (GB enviados en el mes) y la retención (GB almacenados).
- El volumen facturado es el de los datos enriquecidos y normalizados al final del pipeline de ingesta, antes de la compresión de Elasticsearch.
- Según la documentación, la elección del agente de recopilación, incluido OpenTelemetry, no cambia el coste.
- La retención se configura por flujo de datos (
data_retention): es la palanca más sencilla.
Cómo se calcula el coste de Elastic Observability Serverless
La página Observability billing dimensions describe dos dimensiones de datos. La ingesta se «mide por el número de GB de datos que envías a tu proyecto de Observability durante un mes». La retención se «mide por la cantidad total de datos ingeridos almacenados» en el proyecto. Los logs y las trazas siguen la tarifa estándar; no forman una línea de facturación aparte.
Hay una excepción para las métricas. Según la misma página, las métricas almacenadas en modo de índice de series temporales se facturan al 25 % de la tarifa estándar de retención por GB, y el mismo factor se aplica a su ingesta. Las tarifas de métricas publicadas han cambiado: la página de precios menciona una nueva tarificación con efecto desde el 1 de julio de 2026.
Qué mide exactamente el volumen de ingesta
Según esta documentación, el volumen se calcula sobre el tamaño de los datos «totalmente enriquecidos y normalizados» al final del pipeline de ingesta, antes de la compresión de Elasticsearch. Consecuencia práctica: el volumen facturado puede superar el tamaño del índice en disco, así como los volúmenes que aparecen en los logs de un proxy del proveedor cloud. Por tanto, no dimensiones a partir del tamaño de los índices de un clúster anterior ni del tráfico de red.
Un punto tranquilizador para los equipos que estandarizan sobre OpenTelemetry: la página indica que la arquitectura de ingesta (Elastic Agent, Logstash, OpenTelemetry u otros recopiladores) no influye en el coste. Tratamos estas rutas en nuestro artículo sobre Elastic Agent y el recopilador OpenTelemetry.
Las tarifas publicadas, con fecha y reservas
La página Serverless Observability pricing, consultada el 30 de octubre de 2026, muestra dos niveles de funcionalidades. Los importes están en dólares («$»); la página no nombra la divisa.
| Nivel | Ingesta (logs, trazas, otros) | Retención (logs, trazas, otros) |
|---|---|---|
| Logs Essentials | desde 0,07 $ por GB | desde 0,017 $ por GB al mes |
| Complete | desde 0,09 $ por GB | 0,019 $ por GB al mes |
Para las métricas, la página muestra 0,023 $ por GB en la ingesta y 0,005 $ por GB al mes de retención en el nivel Complete. Ojo con la expresión «desde»: son mínimos mostrados, no un precio garantizado para tu volumen. Todo cálculo hecho con estas cifras es, pues, una estimación a la baja. Para un presupuesto firme, recurre a la calculadora o al equipo comercial de Elastic.
Dimensionar ingesta y retención paso a paso
Este es un método en cuatro pasos. Sirve para un proyecto Observability en Elastic Cloud Serverless; no se aplica ni a Dynatrace Managed ni a Dynatrace SaaS.
- Mide el volumen bruto por fuente. Cuenta los GB por día de cada fuente (logs de aplicación, trazas, métricas) antes de la compresión, teniendo en cuenta el enriquecimiento que añaden tus pipelines.
- Multiplica por 30 para obtener la ingesta mensual.
- Decide la retención por tipo de datos. Las trazas de depuración no necesitan la misma duración que los logs de auditoría.
- Calcula el stock almacenado: volumen diario multiplicado por el número de días conservados, una vez alcanzado el régimen estable.
Ejemplo con 50 GB diarios de logs en el nivel Complete, con las tarifas mínimas anteriores. La ingesta representa 1500 GB al mes, es decir, 135 $. Con 30 días de retención, el stock alcanza 1500 GB, es decir, 28,5 $ al mes; con 90 días, 4500 GB, es decir, 85,5 $ al mes.
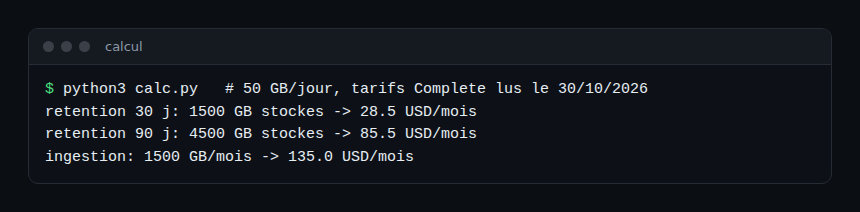
El cálculo muestra un orden de magnitud útil: pasar de 30 a 90 días triplica el stock almacenado, pero no afecta a la ingesta. Aquí, la ingesta pesa más que la retención. Reducir el volumen enviado sigue siendo, por tanto, la primera palanca, y la retención la segunda. Este resultado procede de nuestra aritmética sobre tarifas mínimas, no de una medición.
No hemos verificado si la retención cuenta el mismo volumen «enriquecido» que la ingesta o el tamaño comprimido: la documentación leída no lo precisa. Prevé un margen y compara la primera factura con tu estimación.
Configurar la retención en una plantilla de índice
Según la documentación sobre la retención de los flujos de datos, el parámetro data_retention se fija por flujo de datos. Para los flujos nuevos, se coloca en una plantilla de índice; el nombre logs-app-* de abajo es un ejemplo.
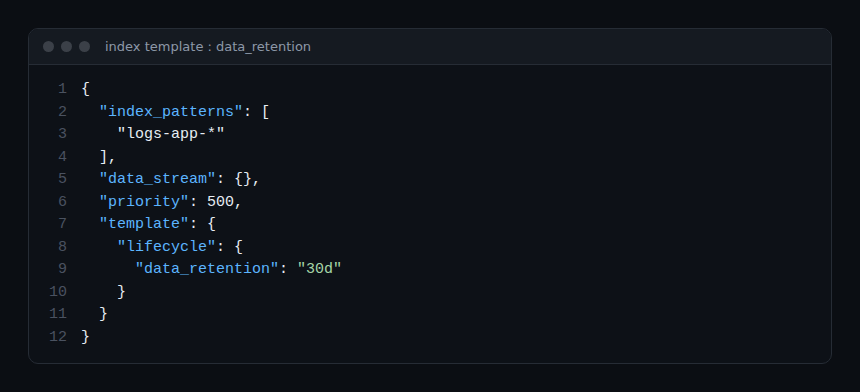
{
  "index_patterns": ["logs-app-*"],
  "data_stream": {},
  "priority": 500,
  "template": {
    "lifecycle": {
      "data_retention": "30d"
    }
  }
}
Modificar un flujo existente
Para un flujo ya creado, la referencia de la API de Elasticsearch Serverless da la solicitud PUT /_data_stream/{name}/_lifecycle. El parámetro data_retention fija la duración mínima de conservación de los documentos; un valor vacío los conserva indefinidamente.
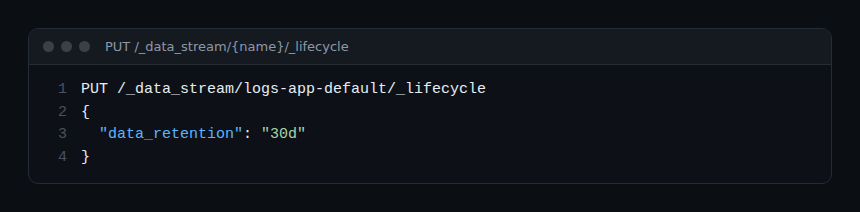
PUT /_data_stream/logs-app-default/_lifecycle
{
  "data_retention": "30d"
}
En Kibana, la página Streams también ofrece una pestaña Retention para consultar y ajustar la retención de un flujo. Sin configuración, la retención efectiva es infinita: es el valor predeterminado documentado y, por tanto, un riesgo de coste que crece en silencio. Los ajustes a escala de clúster data_streams.lifecycle.retention.default y data_streams.lifecycle.retention.max existen en la página de la documentación; no hemos verificado su disponibilidad en un proyecto Serverless, que no expone necesariamente los ajustes de clúster. Además, indica que las instantáneas buscables (frozen_after) no están disponibles en Serverless: el nivel frozen descrito en nuestro artículo sobre el nivel frozen no se aplica aquí.
Cómo comprobar que funciona
- Consulta el flujo con la API Get data stream lifecycle: la respuesta debe mostrar
"lifecycle": {"enabled": true}y tudata_retention. - Compara, una vez por semana, el volumen enviado con tu estimación diaria. Una diferencia duradera señala una fuente demasiado verbosa.
- Tras el primer mes completo, contrasta la factura con tu cálculo y ajusta el factor de margen.
Buenas prácticas para controlar el coste
- Filtra en el origen. Elimina los logs de nivel debug en producción en el recopilador, antes de la ingesta. Un muestreo de trazas, como el tail sampling, también reduce el volumen enviado.
- Define una retención por flujo en lugar de dejar el valor infinito predeterminado.
- Vigila los enriquecimientos. Cada campo añadido por un pipeline aumenta el tamaño facturado.
- Trata el coste como un SLI interno. Un presupuesto de ingesta por servicio, vinculado a tus SLO, evita sorpresas.
Si comparas con otras plataformas, mantén el mismo método: volumen, retención, unidad de facturación. Nuestra comparativa Dynatrace y Datadog muestra que no facturan las mismas unidades. Para las nociones de fondo, consulta también observabilidad y monitorización, y nuestra guía sobre la retención y el almacenamiento de datos en Dynatrace.
Preguntas frecuentes
¿El coste de Elastic Observability Serverless depende del agente utilizado?
No, según la página de facturación de Elastic: la arquitectura de ingesta (Elastic Agent, Logstash, OpenTelemetry u otros recopiladores) no afecta al coste. Solo cuenta el volumen medido al final del pipeline.
¿Por qué mi factura supera el tamaño de mis índices?
Porque el volumen facturado es el de los datos enriquecidos y normalizados antes de la compresión de Elasticsearch. Por tanto, puede superar el tamaño del índice y los volúmenes vistos por un proxy cloud.
¿Cuál es la retención predeterminada?
Sin configuración, la documentación indica que la retención efectiva es infinita y que los datos se conservan indefinidamente. Fija data_retention en cada flujo para acotar el stock.
Conclusión
Para estimar el coste de Elastic Observability Serverless, mide el volumen bruto enriquecido, multiplícalo por la duración de retención deseada y aplica después las tarifas leídas en la página oficial, indicando su fecha. Reduce primero la ingesta y acota después la retención flujo por flujo.
Fuentes
- Observability billing dimensions, documentación de Elastic
- Serverless Observability pricing, Elastic (consultada el 30 de octubre de 2026)
- Data stream retention, documentación de Elastic
- Put data stream lifecycle, API de Elasticsearch Serverless
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Elastic N.V. Los nombres de productos citados pertenecen a sus respectivos propietarios; las tarifas son las que muestra el editor en la fecha indicada, y los ejemplos de nombres de flujo son ficticios. Comprueba siempre los valores en la documentación oficial correspondiente a tu versión.