Flex Logs de Datadog es un nivel de almacenamiento de logs que separa el almacenamiento del cálculo: conservas durante mucho tiempo grandes volúmenes y pagas aparte la capacidad de consulta. Según la documentación de Datadog, busca ofrecer consultas «live» económicas sobre una retención larga. La pregunta real para un equipo SRE no es «¿hay que activarlo?» sino «¿qué logs salen de la indexación estándar y cuáles deben quedarse en ella?».
Este artículo propone una guía de decisión basada únicamente en la documentación oficial consultada el 30 de octubre de 2026. No da ninguna tarifa: los precios cambian, léelos en la página oficial de Datadog. El contenido vale para Datadog; para Dynatrace, la comparación se refiere a los conceptos, no a una equivalencia de funciones.
En resumen
- Datadog describe tres opciones: indexación estándar, Flex Logs y archivado.
- Flex Logs no admite monitors ni Watchdog; los dashboards sí.
- El compute es la capacidad de consulta, dimensionada según el número de eventos almacenados.
- Los logs que sirven para alertar deben quedarse en la indexación estándar.
Flex Logs de Datadog: las tres opciones de la documentación
La documentación distingue tres usos. La indexación estándar encaja con los logs que se consultan a menudo y se conservan poco tiempo, como los logs de aplicación. Flex Logs encaja con los logs que se conservan mucho tiempo pero que a veces hay que consultar con urgencia: seguridad, transacciones, red. El archivado encaja con los logs que se consultan raramente y se almacenan mucho tiempo, como los de auditoría o configuración.
Estas opciones se combinan. La documentación indica que se pueden mantener logs en la indexación estándar y luego prolongar su duración con Flex Logs. Los filtros de un índice se aplican también a su nivel Flex.
El archivado es otro mecanismo. Según la página Log Archives, envía todos los logs ingeridos, indexados o no, a un bucket de tu propiedad (AWS S3, Azure Storage o Google Cloud Storage). Después se accede a ellos mediante rehidratación o búsqueda en el archivo.
Lo que Flex Logs no hace: monitors y Watchdog
Este es el límite que lo decide todo. La documentación es explícita: los monitors no se admiten, Watchdog tampoco. Los dashboards funcionan, pero sus consultas cuentan en el dimensionamiento del compute.
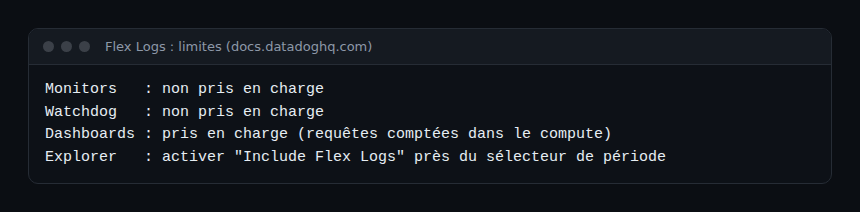
Consecuencia para un SRE: un log que alimenta una alerta sobre un SLO no puede vivir solo en Flex. Un log de auditoría o de flujos de red que se consulta únicamente después de un incidente, sí. El criterio es simple: ¿este log dispara algo o sirve sobre todo para investigar? Para la distinción entre alertar y explorar, consulta nuestro artículo sobre la observabilidad frente a la monitorización.
Entender el compute y la retención
Los tamaños de compute
El compute es la capacidad de consulta de Flex Logs. Según la documentación, no se usa para la ingesta ni para la búsqueda en los logs que están solo en la indexación estándar. Los tamaños son Starter, XS, XS+, S, M y L; cada uno ofrece aproximadamente el doble de rendimiento y capacidad que el anterior. La capacidad está limitada por el número de consultas simultáneas y por el máximo de logs escaneados por consulta.
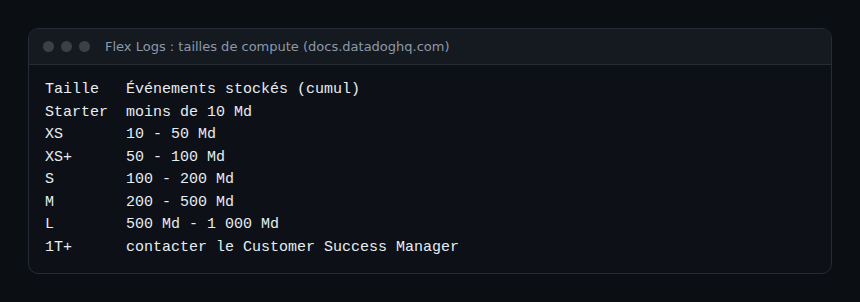
Estos umbrales son las recomendaciones de la documentación. Según Datadog, Starter se factura a una tarifa conjunta de almacenamiento más compute, y los tamaños XS a L a una tarifa fija. Cuando se alcanza la capacidad, las consultas se ralentizan y se relanzan; las que reintentan demasiado a menudo pueden fallar, con el mensaje «Flex Logs compute capacity is constrained».
La retención
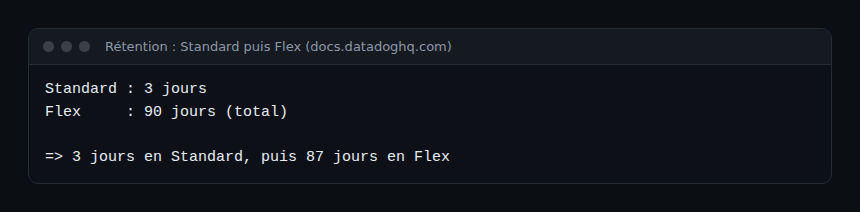
Según la documentación, la retención de Starter es de 3, 6, 12 o 15 meses; la de los tamaños escalables va de 30 a 450 días. Si un índice combina los dos niveles, los logs permanecen en estándar hasta el final de la retención estándar y luego pasan a Flex durante el resto.
Guía de decisión: qué logs sacar de la indexación estándar
La documentación cita fuentes candidatas a un envío directo a Flex: registros de auditoría (CloudTrail, auditoría de Kubernetes), CDN, CI/CD, DNS, identidad, balanceadores de carga, equipos de red y service meshes. Esta es una guía de lectura, que es nuestra interpretación y no una recomendación del proveedor.
| Pregunta | Si es sí | Si es no |
|---|---|---|
| ¿Un monitor o Watchdog se apoya en este log? | Mantener en estándar | Candidato a Flex |
| ¿Hay que conservarlo más tiempo que la retención estándar? | Ampliar con Flex | Quedarse en estándar |
| ¿Casi nunca se consulta, pero lo exige el cumplimiento normativo? | Flex o archivado | Estándar |
| ¿Hay que buscarlo en directo después de un incidente? | Flex mejor que archivo | Archivado |
Un consejo útil: antes de mover un flujo, haz una lista de los monitors de logs existentes. Si alguno consulta ese flujo, crea una métrica basada en logs o mantén ese subconjunto en estándar. Los filtros de exclusión de los índices sirven para retirar del índice los logs sin valor, que siguen disponibles en Livetail, en los archivos y en las métricas basadas en logs.
Configurar un nivel Flex paso a paso
- Comprueba que tienes el permiso
flex_logs_config_write: la activación se hace a nivel de la organización. - Abre la página Flex Logs Control, elige el tipo de compute y el tamaño, y haz clic en Enable Flex Logs. Se recomienda Starter por debajo de 10 mil millones de logs almacenados.
- En Indexes Configuration, modifica o crea un índice, selecciona Flex Tier y ajusta la retención en Configure Storage Tier and Retention.
- En el Log Explorer, activa «Include Flex Logs» junto al selector de período para consultar este nivel.
Para pasar de un índice estándar a un índice con Flex, la documentación precisa que la retención se amplía tanto a los logs existentes como a los nuevos. Las subidas de tamaño de compute se pueden hacer en cualquier momento; las bajadas, una vez cada 15 días.
Cómo comprobar que funciona
- En el Log Explorer, marca «Include Flex Logs» y comprueba que aparecen logs más antiguos que la retención estándar.
- Lanza una consulta representativa de una investigación real y observa su duración. El mensaje de capacidad limitada indica un compute infradimensionado.
- Verifica que ningún monitor de logs se haya quedado mudo: un monitor sobre un flujo que ha pasado solo a Flex ya no verá esos logs. Este punto debe probarse en tu entorno, ya que la documentación indica únicamente que los monitors no se admiten.
Buenas prácticas
- Migra un flujo cada vez, empezando por los logs de auditoría o de red sin alertas.
- Mantén en la indexación estándar los logs de error de aplicación ligados a tus SLO.
- Reevalúa el tamaño de compute cuando el acumulado de eventos cambie de tramo.
- Mantén al día la lista de flujos y de su nivel: es toil evitable para la guardia (on-call).
¿Y en OpenTelemetry y Dynatrace?
La elección del nivel se produce después de la ingesta: un Collector de OpenTelemetry envía los mismos logs sea cual sea el destino, y la clasificación se hace en la configuración de los índices. Es un buen argumento para filtrar y enriquecer pronto, como en nuestro artículo sobre el Collector de OpenTelemetry en Kubernetes. Para comparar los enfoques de coste en materia de retención, consulta también la ingesta de APM y la retención de spans en Datadog y nuestra comparativa de Dynatrace y Datadog.
En Dynatrace, según la documentación, los logs van a buckets de Grail cuya retención va de 10 días a 10 años (35 días para el bucket default_logs). Un procesador de OpenPipeline asigna los registros a un bucket, lo que separa los logs por duración de conservación. El modelo es distinto del de Datadog: no busques una equivalencia término a término.
Si comparas con Elastic, nuestro artículo sobre el frozen tier de Elasticsearch trata el mismo equilibrio entre coste y latencia.
Preguntas frecuentes
¿Flex Logs sustituye a la indexación estándar?
No. La documentación presenta opciones complementarias: se pueden conservar logs en estándar y luego prolongar con Flex. Los monitors y Watchdog siguen ligados a la indexación estándar.
¿Qué diferencia hay con el archivado?
El archivo es un almacenamiento en tu propio bucket, al que se accede mediante rehidratación o búsqueda en el archivo. Flex Logs sigue siendo consultable en el Log Explorer con una capacidad de compute dedicada.
¿Dónde encontrar los precios?
Únicamente en la página de precios oficial de Datadog, que es la que vale y puede cambiar. No citamos ningún precio procedente de sitios de terceros.
Conclusión
Sacar logs de la indexación estándar es una decisión de fiabilidad tanto como de coste. Mantén en estándar lo que alerta, envía a Flex lo que se consulta mucho tiempo después, archiva el resto. Prueba primero con un flujo sin monitor.
span.observer es un blog independiente de la comunidad, no afiliado a Dynatrace LLC ni a Datadog Inc. Dynatrace es una marca de Dynatrace LLC. Los nombres de productos pertenecen a sus propietarios; los valores proceden de la documentación oficial consultada el 30 de octubre de 2026 y pueden cambiar. Comprueba siempre los valores (puertos, versiones, tamaños) en la documentación oficial correspondiente a tu versión.