يقرر tail-based sampling APM Server الاحتفاظ بالتتبّع أو التخلي عنه بعد أن يراه كاملًا، مما يسمح بحفظ جميع الأخطاء وتقليص البقية. وفق وثائق Elastic، يُتخذ القرار في نهاية التتبّع، وليس في بدايته كما في head-based sampling.
يركّز هذا الدليل على الإعدادات التي تسبب مشكلات عند إهمالها: interval وttl وstorage_limit والسلوك عند امتلاء القرص. وهو يكمّل مقالنا عن tail sampling في OpenTelemetry قبل Dynatrace الذي يتناول نهج Collector. هنا كل شيء يحدث داخل APM Server، في جانب Elastic.
جميع القيم أدناه مأخوذة من صفحتي الإعداد والتقديم الخاصتين بـ tail-based sampling في وثائق Elastic (إصدار «current» الذي اطُّلع عليه في 30 أكتوبر 2026)، ما لم يُذكر خلاف ذلك.
باختصار
- لا يعمل tail-based sampling في APM Server إلا مع مخرج Elasticsearch ويتطلب صلاحيات مشددة.
- تنتظر الأحداث قرارها على القرص المحلي، لا في الذاكرة: التخزين وTTL هما الإعدادان الحرجان.
- افتراضيًا، قيمة
ttlهي30mوintervalهي1mوstorage_limitهي0GB(حتى 80% من القرص). - عند الامتلاء: افتراضيًا تُفهرس الأحداث دون أخذ عينات، وقد يؤدي ذلك إلى إجهاد Elasticsearch.
tail-based sampling APM Server: المبدأ والمتطلبات
في head-based sampling، تُسحب كل معاملة بالقرعة منذ بدايتها دون معرفة ما إذا كانت ستفشل. أما في tail-based sampling، فيحتفظ APM Server بأحداث التتبّع بانتظار نهاية المعاملة الجذرية، ثم يطبّق السياسات. توضح الوثائق أن أخذ العينات عشوائي موزون: التتبّعات التي تستغرق معاملتها الجذرية وقتًا أطول لديها فرصة أكبر للاحتفاظ بها. تُحسب المقاييس على جميع الأحداث، سواء أُخذت عيّنة منها أم لا، وتُحفظ الأخطاء مهما كان القرار.
المتطلبات المذكورة في الوثائق: مخرج Elasticsearch (المخارج الأخرى غير مدعومة)، وصلاحيات مشددة تُمنح عبر دور مخصص، والتوفر على Elastic Stack (وليس على Elastic Cloud Serverless). يشمل ذلك وكلاء Elastic APM وحزم OpenTelemetry SDK؛ وبالنسبة لـ OpenTelemetry توصي الوثائق بهذه الآلية بدل tailsamplingprocessor بسبب قيود الأخير.
كتابة سياسات أخذ العينات
يجب أن تحتوي السياسة على sample_rate بين 0 و1. الشروط الاختيارية هي trace.name (اسم المعاملة الجذرية) وtrace.outcome (success أو failure أو unknown) وservice.name وservice.environment. تُقيَّم السياسات بالترتيب، ويجب أن تتحقق جميع شروط السياسة، ويجب أن تنتهي القائمة بسياسة تحدد sample_rate فقط. بدونها تُرفض المعاملة التي لا تطابق أي سياسة مع الخطأ «no matching policy».
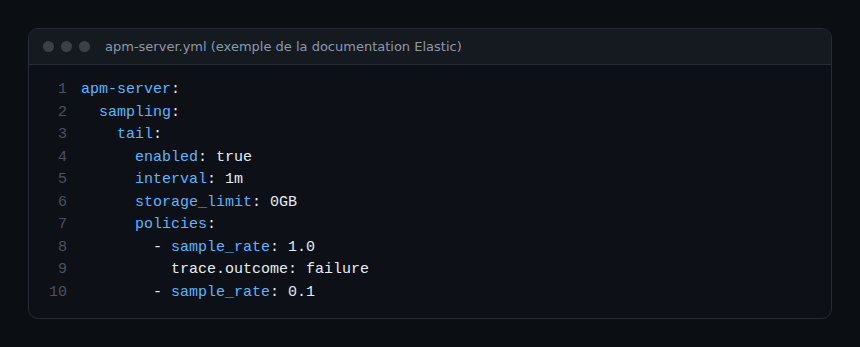
يحتفظ هذا المثال من الوثائق بجميع التتبّعات الفاشلة وبنسبة 10% من الباقي. تُطبَّق القواعد على مستوى التتبّع، بحسب الخدمة التي بدأته، وليس بحسب خدمة أو span منفرد.
ضبط interval وTTL وstorage_limit
الخطوة 1: interval
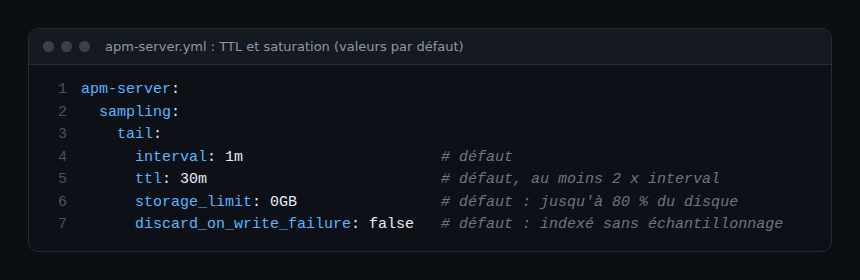
القيمة apm-server.sampling.tail.interval (الافتراضي 1m) هي فاصل المزامنة بين عدة خوادم APM Server. توصي الوثائق بقيمة بين عشرات الثواني وبضع دقائق. أرسل جميع خدمات التتبّع إلى مجموعة APM Server نفسها: إذا لم تصل المعاملة الجذرية أبدًا، تضيع الأحداث بصمت.
الخطوة 2: TTL
تحدد القيمة apm-server.sampling.tail.ttl (الافتراضي 30m) المدة التي تنتظر فيها الأحداث قرارًا في التخزين المحلي. يجب ألا تقل عن ضعف interval. إذا انتهت مهلة TTL قبل اتخاذ القرار، يُحذف الحدث دون فهرسته. ويتطلب TTL الأطول مساحة قرص أكبر. في Fleet يظهر حقل TTL ابتداءً من الإصدار 9.1.
الخطوة 3: storage_limit
القيمة apm-server.sampling.tail.storage_limit (الافتراضي 0GB): عند الصفر يمكن لـ APM Server استخدام ما يصل إلى 80% من القرص الذي يحمل قاعدة أخذ العينات. تضع قيمة بوحدة GB حدًا للاستخدام. منذ الإصدار 9.0.0 يكون حد التخزين غير محدود افتراضيًا لكن الكتابة تتوقف عند إشغال 80%، وقد يتجاوز الاستخدام الفعلي الحد قليلًا.
السلوك عند امتلاء التخزين
عندما يمتلئ القرص، يسجّل APM Server الرسالة «configured limit reached». بعد ذلك يعتمد كل شيء على discard_on_write_failure:
false(الافتراضي): تتخطى الأحداث أخذ العينات وتُفهرس فورًا فيtraces-apm-*. تصبح النسبة الفعلية 100%، وقد يؤدي ذلك إلى إجهاد Elasticsearch.true: تُحذف الأحداث. يبقى حمل الفهرسة محدودًا، لكن تضيع بعض التتبّعات وقد تظهر ناقصة.
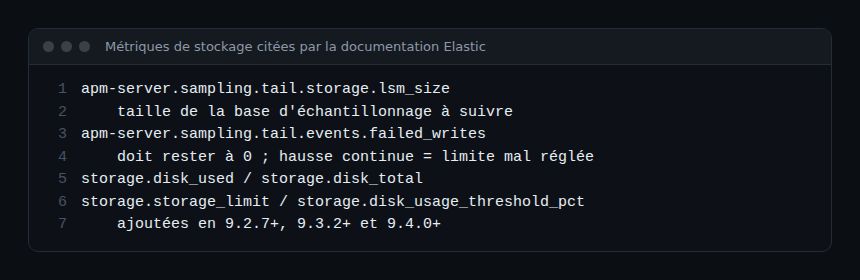
الاختيار مفاضلة لدى فريق المنصة: حماية Elasticsearch أو حماية اكتمال التتبّعات. تضيف الإصدارات 9.2.7+ و9.3.2+ و9.4.0+ عتبة لاستخدام القرص: وما فوقها تُرفض الكتابات الجديدة ويُطبَّق هذا السلوك. وفق الوثائق يجب أن يكون القرص سريعًا (SSD بمعدل IOPS مرتفع)، لأن الكتابات تزداد مع معدل الاستيعاب.
المراقبة وتحديد الحجم
فعّل مراقبة APM Server وتابع lsm_size لمعرفة الإشغال. يجب أن يبقى العدّاد failed_writes عند 0؛ والارتفاع المستمر يدل على حد مضبوط بشكل سيئ. انتبه كذلك إلى الخطأ «too many open files»: تحقق من LimitNOFILE في systemd أو من ulimit -n. لفهم سبب الاحتفاظ بالتتبّعات النادرة رغم الحجم، راجع قابلية الملاحظة والمراقبة.
ماذا يتغير بالنسبة لفريق SRE
ينقل tail-based sampling التكلفة من الشبكة إلى القرص: يصبح تحديد حجم التخزين مهمة تشغيلية. تختلف المقاربات بحسب الأداة: في OpenTelemetry Collector يُبقي tailsamplingprocessor الـ spans في الذاكرة (decision_wait بقيمة 30 ثانية وnum_traces بقيمة 50000 افتراضيًا وفق README الخاص به) ويتطلب وصول جميع spans التتبّع إلى النسخة نفسها؛ راجع دليلنا عن Collector على Kubernetes. للحصول على نظرة عامة على المزوّدين، اقرأ مقارنة Dynatrace وDatadog. لا نؤكد وجود أي تكامل بين APM Server وDynatrace.
أفضل الممارسات
- أنهِ القائمة دائمًا بسياسة تحتوي على
sample_rateوحده. - اجعل TTL ضعف الفاصل على الأقل، واحسب القرص اللازم قبل إطالته.
- قرّر مسبقًا قيمة
discard_on_write_failure، ثم أنشئ تنبيهًا علىfailed_writes. - اختبر في بيئة غير حرجة قبل الإنتاج.
الأسئلة الشائعة
ما القيمة الافتراضية لـ TTL في tail-based sampling؟
وفق وثائق Elastic، قيمة apm-server.sampling.tail.ttl هي 30m، بحد أدنى يساوي ضعف الفاصل.
ماذا يحدث عندما يمتلئ التخزين؟
افتراضيًا تُفهرس الأحداث دون أخذ عينات، وقد يؤدي ذلك إلى إجهاد Elasticsearch. وعند ضبط discard_on_write_failure: true تُحذف.
هل يعمل tail-based sampling مع مخرج غير Elasticsearch؟
لا، تشير الوثائق إلى أنه مدعوم فقط مع مخرج Elasticsearch.
المصادر
- Transaction sampling، وثائق Elastic
- Tail-based sampling configuration، وثائق Elastic
- Tail sampling processor، OpenTelemetry
span.observer مدوّنة مجتمعية مستقلة وغير تابعة لشركة Dynatrace LLC ولا لشركة Elastic N.V. العلامات المذكورة تعود إلى مالكيها؛ والقيم مأخوذة من وثائق Elastic: تحقق دائمًا منها في الوثائق الرسمية الخاصة بإصدارك.