حجم shard في Elasticsearch يحدد سرعة عمليات البحث والذاكرة التي يستهلكها العنقود (cluster) وسهولة تشغيله. إذا كانت الـ shards صغيرة جدًا تراكمت وأرهقت العقدة الرئيسية (master)، وإذا كانت كبيرة جدًا أبطأت الاسترداد بعد الحوادث. تجمع هذه المقالة المراجع الرسمية وترشدك إلى تطبيقها مع rollover في ILM.
الهدف: تحديد حجم مستهدف، وأتمتته في سياسة ILM، ثم التحقق من النتيجة. الأرقام أدناه مأخوذة من صفحة Size your Elasticsearch shards (اطُّلع على الصفحة في 30 أكتوبر 2026، دون رقم إصدار ظاهر). هذه مراجع من Elastic وليست قياسات من span.observer، فاختبرها على بياناتك.
باختصار
- بحسب Elastic، استهدف shards بحجم 10 GB إلى 50 GB وأقل من 200 مليون مستند لكل shard.
- الفخ المعتاد هو التجزئة المفرطة (oversharding): كثرة الـ shards الصغيرة تكلّف أكثر من shard واحد كبير.
- الـ rollover حسب الحجم (
max_primary_shard_size) يتجنب الفهارس الصغيرة جدًا التي تُنشأ «في ساعة ثابتة». - الـ shards غير قابلة للتعديل: تصحيح حجم غير مناسب يتطلب نسخ الفهرس (Split أو Reindex).
حجم shard في Elasticsearch: المراجع الرسمية
تعطي الوثائق ثلاثة مراجع. أولًا الحجم: «aim for shard sizes between 10GB and 50GB». ثم عدد المستندات: أبقه تحت 200 مليون لكل shard. وأخيرًا الحد الصارم في Lucene، وهو 2 147 483 519 مستندًا لكل shard (بما فيها المستندات المحذوفة)، أعلى بكثير من التوصية.
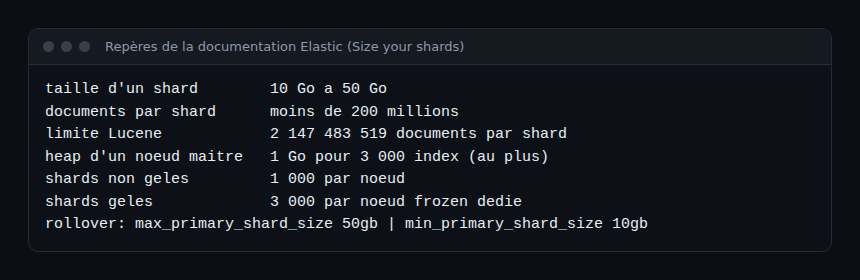
تحدد الوثيقة نفسها حدودًا للعنقود: 1000 shard غير مجمّدة لكل عقدة، و3000 shard مجمّدة لكل عقدة frozen مخصصة. أما العقد الرئيسية فتذكر الوثيقة 3000 فهرس على الأكثر لكل GB من heap. أي إن عقدة رئيسية بذاكرة heap قدرها 4 GB تدعم أقل من 12 000 فهرس، قبل احتساب الذاكرة الأساسية.
بالنسبة لمهندس SRE، الصلة بالموثوقية مباشرة. العنقود الذي يتجاوز هذه الحدود يبطؤ مع كل تغيير في الحالة، ويضر هذا البطء بـ SLO الخاصة بالبحث قبل أن يرن التنبيه. راجع أيضًا دليلنا حول مراقبة Elasticsearch مع Dynatrace.
لماذا تكلّف كثرة الـ shards الصغيرة غاليًا
لكل shard كلفة ثابتة في الذاكرة وفي عمل البحث. ومثال Elastic واضح: البحث في ألف shard بحجم 50 MB يكلّف «بشكل ملحوظ» أكثر من البحث في shard واحد بحجم 50 GB يحوي البيانات نفسها.
بحسب الصفحة، توجد عدة علاجات: تقليل عدد الـ shards بواسطة Shrink، وإعادة فهرسة فهارس الفترات القصيرة إلى فهارس بفترات أطول، وحذف الفهارس الفارغة. كما يقلل force merge عدد الـ segments، لكنه يستهلك موارد كبيرة. شغّله خارج أوقات الذروة، على فهارس لم تعد تكتب فيها.
في المقابل، لا تظهر الـ shards الكبيرة جدًا في هذه الحدود: الصفحة لا تقدّر أثرها في الاسترداد. لذلك لا نؤكده هنا، فقِس زمن النقل بين العقد في عنقودك.
التحكم في الحجم عبر rollover في ILM
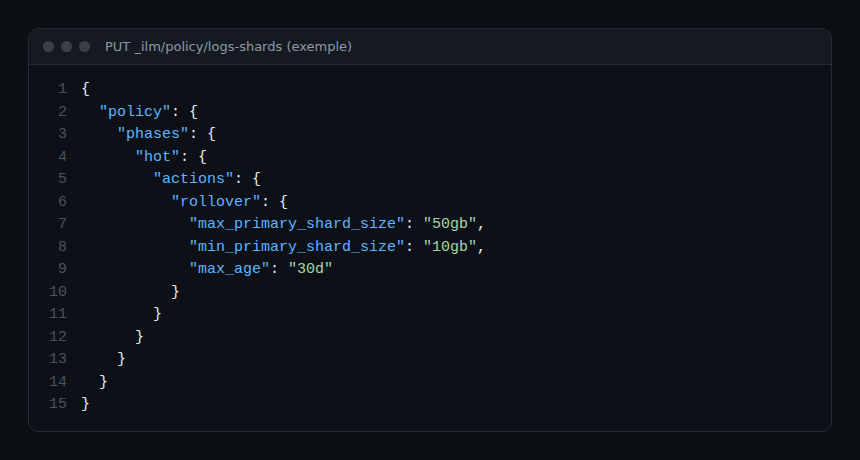
أبسط طريقة للحفاظ على الهدف هي rollover في مرحلة hot ضمن سياسة ILM. بحسب مرجع إجراء rollover، يتطلب الإجراء شرطًا واحدًا على الأقل من نوع max_*، ويحدث الـ rollover عند بلوغ شرط max_* مع تحقق جميع شروط min_* أيضًا.
PUT _ilm/policy/logs-shards
{
  "policy": {
    "phases": {
      "hot": {
        "actions": {
          "rollover": {
            "max_primary_shard_size": "50gb",
            "min_primary_shard_size": "10gb",
            "max_age": "30d"
          }
        }
      }
    }
  }
}
هذه السياسة مثال مبني على الخيارات الموثقة؛ قيمة 30 يومًا اختيار من الكاتب وليست توصية من Elastic. أما حدّا الحجم فمأخوذان من صفحة «Size your shards»: 50 GB كحد أقصى، و10 GB كحد أدنى لتجنب الـ shards الصغيرة جدًا.
نقاط انتباه حول الخيارات
- يستهدف
max_primary_shard_sizeأكبر shard أساسي دون احتساب النسخ المتماثلة (replicas). أماmax_sizeفمُشار إليه على أنه مهجور منذ الإصدار 9.3، وبديلهmax_primary_shard_size. - الـ shard الذي يبلغ 200 000 000 مستند يطلق rollover ضمنيًا. وأي قيمة أعلى لـ
max_primary_shard_docsلا أثر لها. - الفهرس الفارغ لا يخضع لـ rollover افتراضيًا حتى لو بلغ
max_age. أضف"min_docs": 0للسماح بذلك. - تنصح Elastic بعدم الاعتماد على الزمن وحده في الـ rollover، لأنه ينتج غالبًا فهارس صغيرة كثيرة.
الخطوات: تدقيق الـ shards ثم التصحيح
- أحصِ الـ shards من الأكبر إلى الأصغر عبر واجهة cat shards.
- حدّد الفهارس الأقل من 10 GB والتي تتجاوز 50 GB.
- طبّق سياسة ILM لـ rollover حسب الحجم على الفهارس الجديدة.
- صحّح الموجود بواسطة Shrink أو Reindex أو Split بحسب الحالة.
- راقب عدد الـ shards لكل عقدة على مدى الزمن.
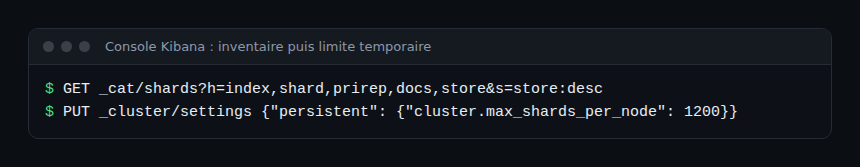
GET _cat/shards?h=index,shard,prirep,docs,store&s=store:descالأعمدة index وshard وprirep (أساسي أو نسخة متماثلة) وdocs وstore مذكورة في مرجع الواجهة. المعامل s يرتّب الناتج. ابحث عن الصفوف التي قيمة store فيها صغيرة جدًا، فهي علامة على التجزئة المفرطة.
إذا بلغ العنقود الحد لكل عقدة، تذكر Elastic مثال رفع cluster.max_shards_per_node إلى 1200، لكنها توضح أن هذا الضبط يجب أن يبقى مؤقتًا. فهو يخفي المشكلة ولا يحلها.
تصحيح shards ذات حجم غير مناسب أصلًا
الـ shards غير قابلة للتعديل. لتغيير عددها أو حجمها يجب نسخ الفهرس: Split لإضافة shards أساسية، وReindex إلى فهرس مضبوط جيدًا للتجميع. بحسب الصفحة، لا يكفي Restore Snapshot ولا Clone Index لهذا الغرض.
كيف تتحقق من أن الأمر يعمل
بعد بضع دورات rollover، أعد تشغيل الطلب _cat/shards. يجب أن تقع الفهارس الجديدة بين 10 GB و50 GB لكل shard أساسي. إذا بقيت فهارس كثيرة صغيرة جدًا، فتحقق من الشرط max_age وأضف عتبة min_primary_shard_size. في Dynatrace يمكنك متابعة عدد الـ shards وزمن استجابة البحث عبر الامتداد (extension) الموصوف في المقالة أعلاه (SaaS أو Managed بحسب الامتداد المنشور).
الصلة بـ OpenTelemetry وبيانات قابلية الملاحظة
تصل تتبعات OpenTelemetry ومقاييسه وسجلاته بحجم متغير: ذروة في الحركة تنتج ذروة في الفهرسة. الـ rollover حسب الحجم يتكيف مع هذا الإيقاع، أما الفهرس اليومي فلا. لتقليل الحجم قبل الفهرس، راجع أخذ العينات المتأخر (tail sampling) في OpenTelemetry، وللفرق بين الإشارات راجع قابلية الملاحظة والمراقبة. ولمقارنة المنصات، تضع مقارنتنا بين Dynatrace وDatadog معايير التشغيل.
أفضل الممارسات
- ابدأ من هدف 10 إلى 50 GB وعدّل باختبارات الحمل الخاصة بك.
- فضّل الـ rollover حسب الحجم أو عدد المستندات على الـ rollover الزمني الخالص.
- لا تستخدم رفع
max_shards_per_nodeإلا كإجراء مؤقت. - جدوِل force merge خارج أوقات الذروة، على فهارس للقراءة فقط.
- وثّق الحجم المستهدف في runbook الخاص بك، دون لوم الفريق الذي أنشأ الفهارس الحالية.
الأسئلة الشائعة
ما الحجم المثالي لـ shard في Elasticsearch؟
توصي Elastic بما بين 10 GB و50 GB، مع أقل من 200 مليون مستند لكل shard. هذا مرجع: الرقم الصحيح يعتمد على استعلاماتك وعتادك.
ماذا يحدث إذا كانت الـ shards صغيرة جدًا؟
يتحمل العنقود كلفة ثابتة لكل shard، وتمر عمليات البحث على عدد أكبر من الـ shards. اجمعها بواسطة Shrink أو Reindex وتجنب الـ rollover الزمني الخالص.
هل يمكنني تغيير حجم shard موجود؟
لا، الـ shard غير قابل للتعديل. يجب نسخ الفهرس بواسطة Split أو Reindex إلى فهرس مضبوط بشكل صحيح.
الخلاصة
احتفظ بقاعدة واحدة: من 10 إلى 50 GB لكل shard، وrollover حسب الحجم، وتدقيق منتظم بواسطة _cat/shards. القيم الدقيقة تحتاج إلى التحقق على بياناتك. الحدود والخيارات المذكورة مأخوذة من صفحات Elastic الرسمية التي اطُّلع عليها في 30 أكتوبر 2026.
هذه المقالة من مدوّنة مستقلة وغير تابعة لشركة Dynatrace LLC ولا لشركة Elastic N.V. Elasticsearch علامة تجارية لشركة Elastic N.V. الأرقام المذكورة هي أرقام الوثائق الرسمية وليست قياسات من span.observer. تحقق دائمًا من القيم (المنافذ والإصدارات والأحجام) في الوثائق الرسمية الخاصة بإصدارك.